Architecture des ordinateurs
Mémoires, périphériques et interruptions
2026-10-07
Les mémoires vives
Registres
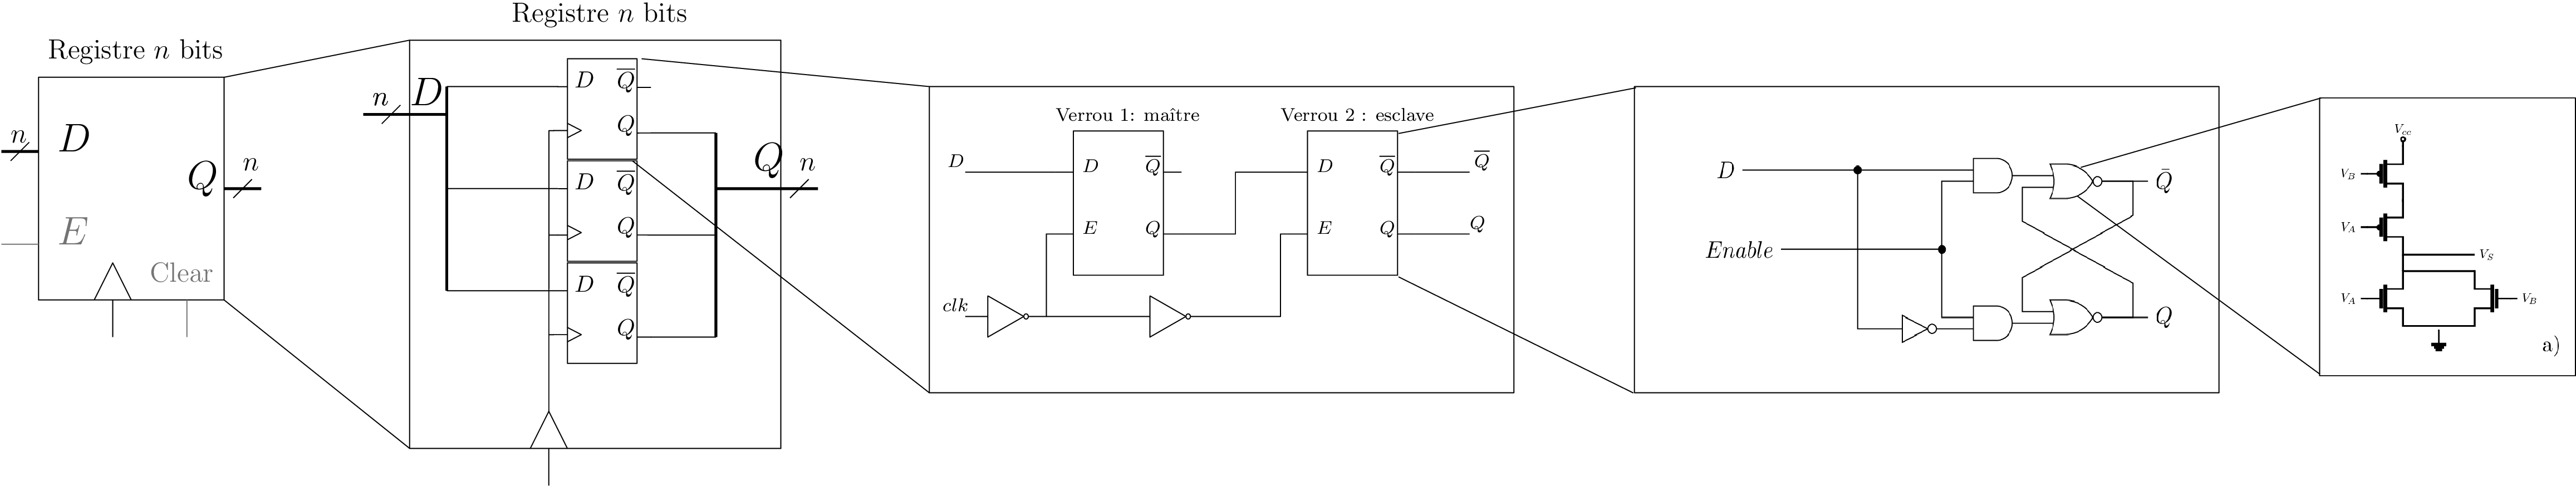
Transistors pour \(n\) bits \(\approx 30 n\) Capacité \(\approx\) 32-64 bits
Temps d’accès \(\approx\) 1 ps (\(10^{-12}s\))
Volatile
Les mémoires vives
Static Random Access Memory (SRAM)
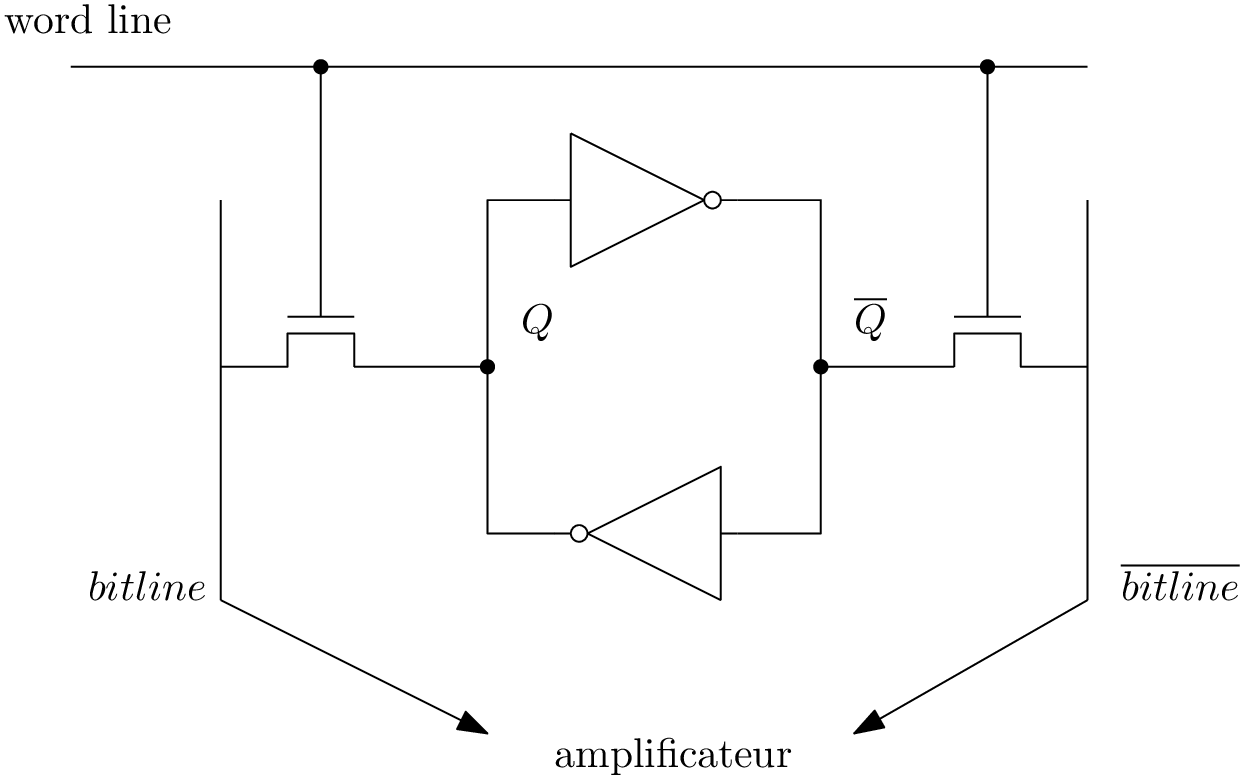
Capacité : 10 Ko - 10 Mo
Temps d’accès \(\approx\) 1ns
Volatile Usage: Caches L1-L2-L3
Les mémoires vives
Dynamic random access memory (DRAM)
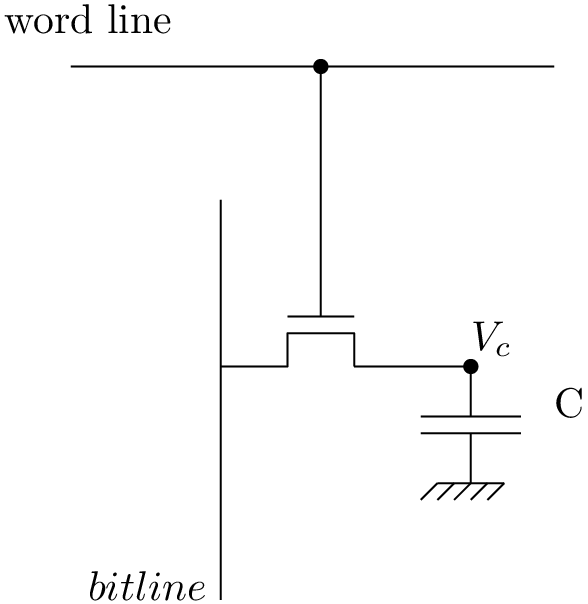
Capacité : 10 Go
Temps d’accès : 80 ns (réécriture toutes les ms)
Volatile Usage : “Les barrettes de RAM”
Les mémoires de masse
Disque dur magnétique
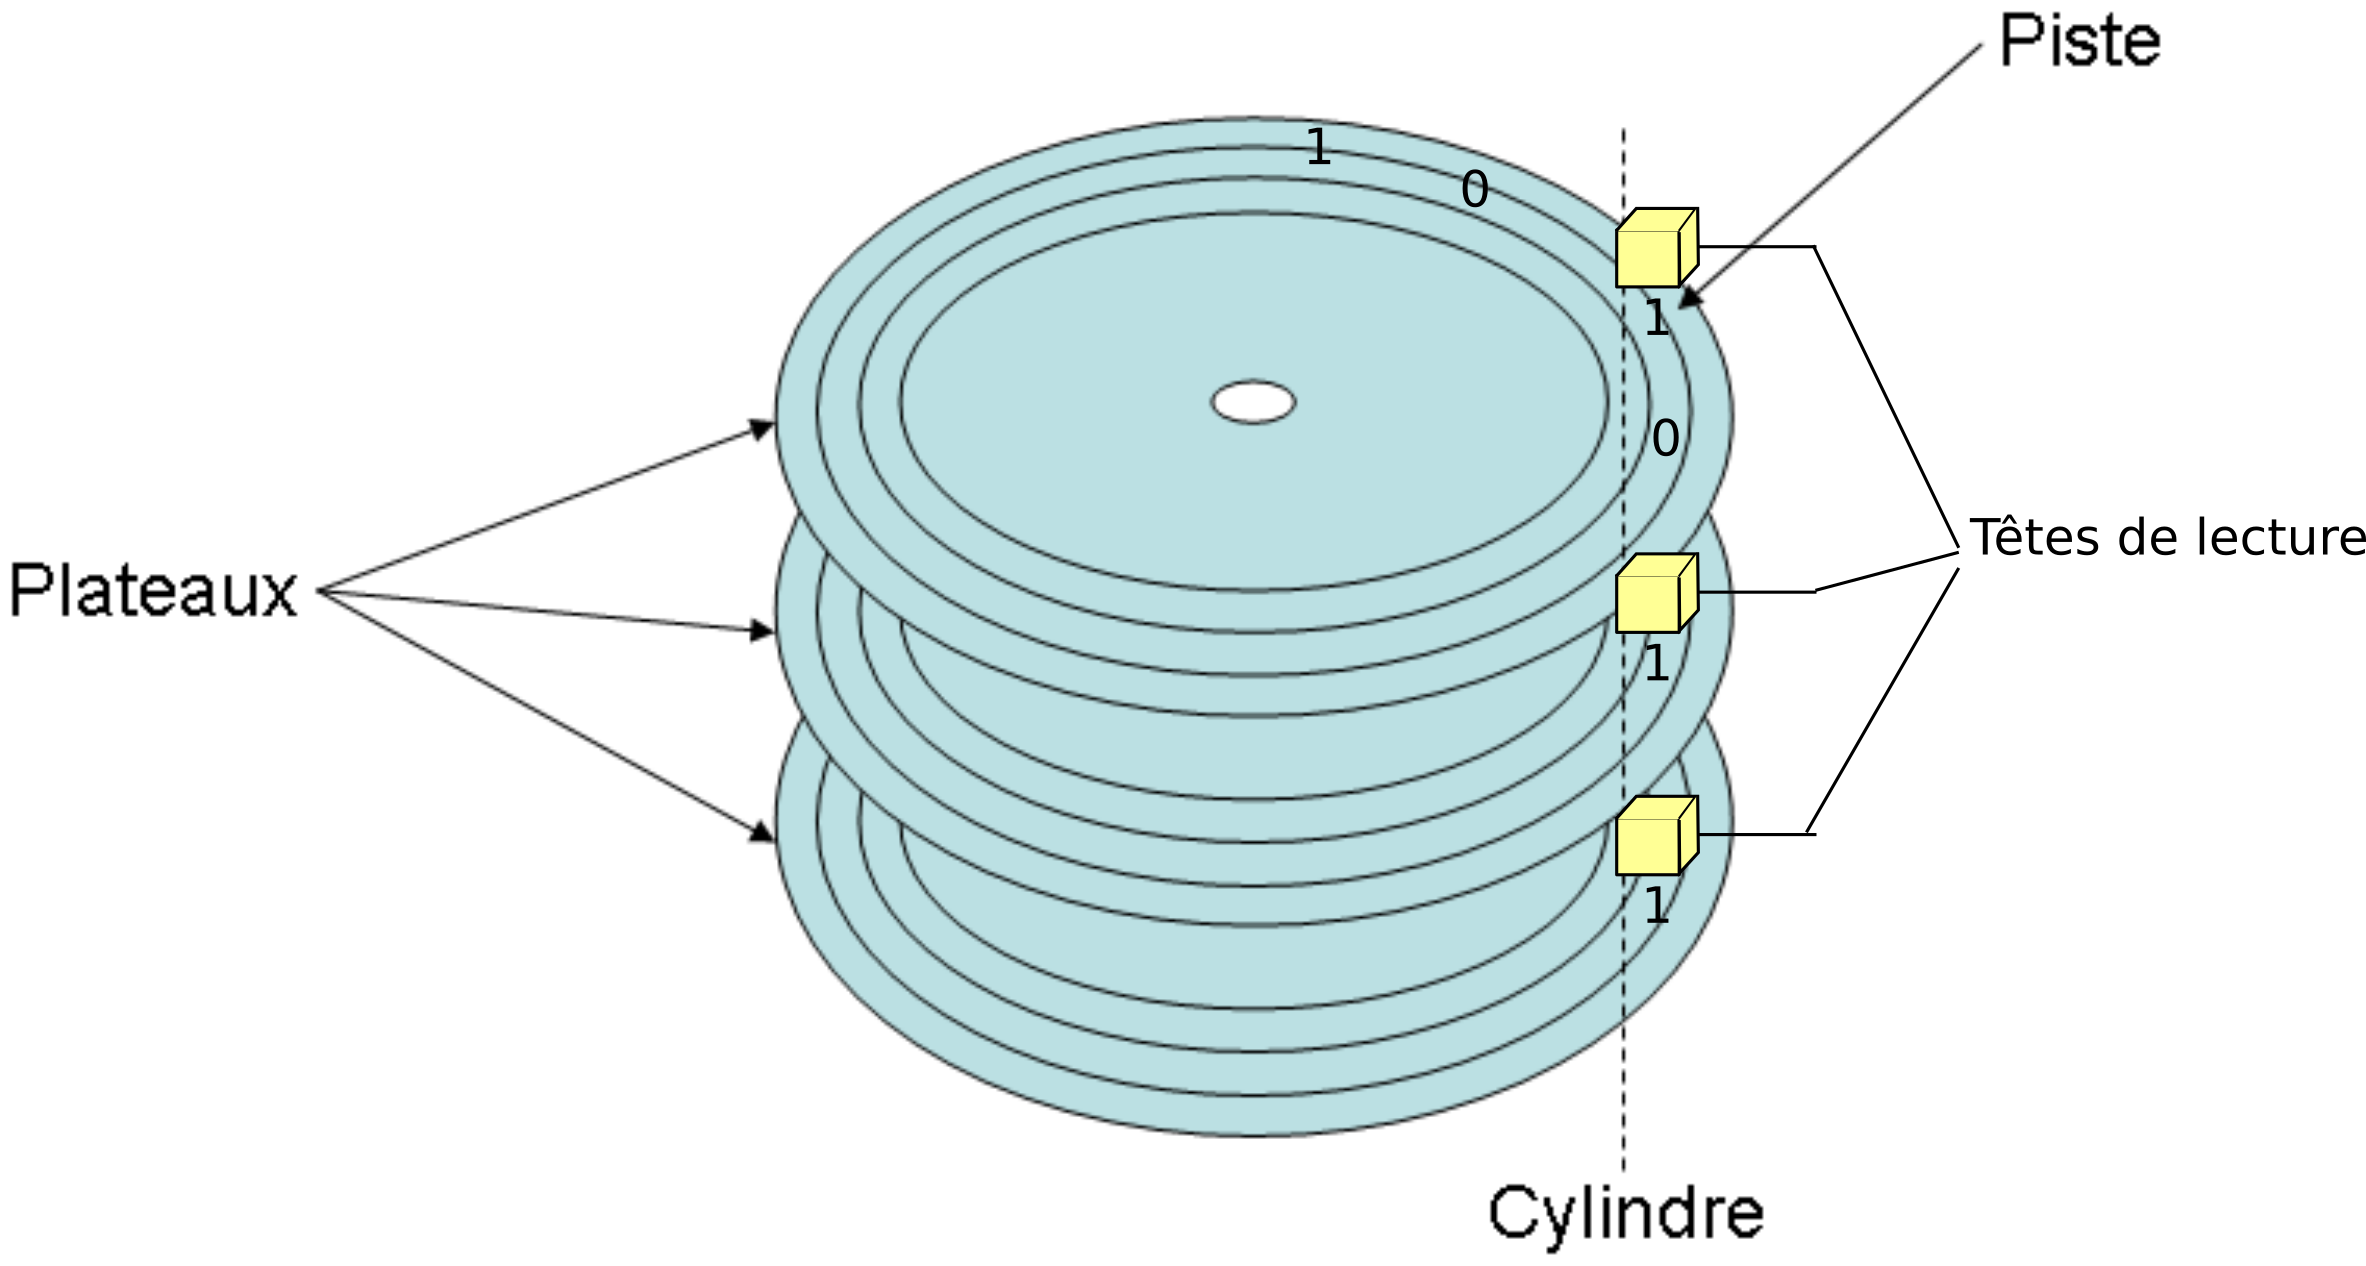
Capacité : 1 To (plusieurs pistes découpées en secteurs de \(512\) octets) Temps d’accès : 10 ms (révolution à \(7400\) tr/min) Non volatile
La clé : le principe de localité
Les principes de localité
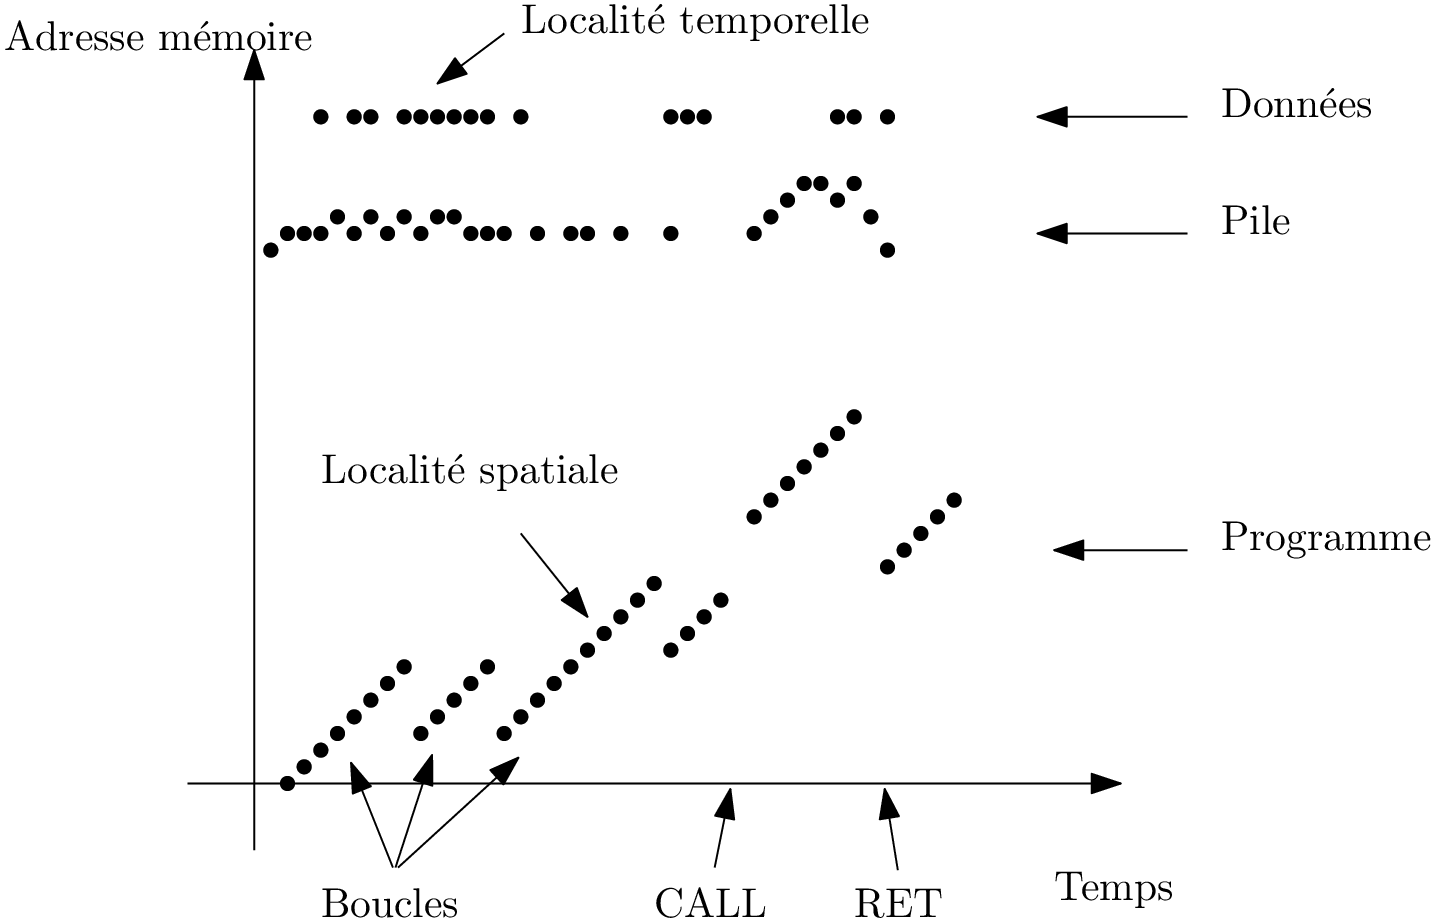
- localité spatiale : les accès futures en RAM se feront à des addresses proches des accès courants
- localité temporelle : une donnée accédée récemment sera certainement réutilisée prochainement
Idée: combiner une petite mémoire rapide avec une grosse mémoire lente
- Localité temporelle : on charge en mémoire rapide une donnée à laquelle on accède
- Localité spatiale : on charge aussi les voisines
Problème de doublons ? Politique de remplacement ? Dépends de la réalisation…
Réalisations matérielles d’un cache
Mémoire à \(2^{16}\) mots, Cache à \(2^{4}\) mots.
1 mot mémoire ne peut aller que dans une ligne de cache.
1 ligne de cache peut possiblement recevoir \(n\) mots mémoires.
Cache à correspondance directe
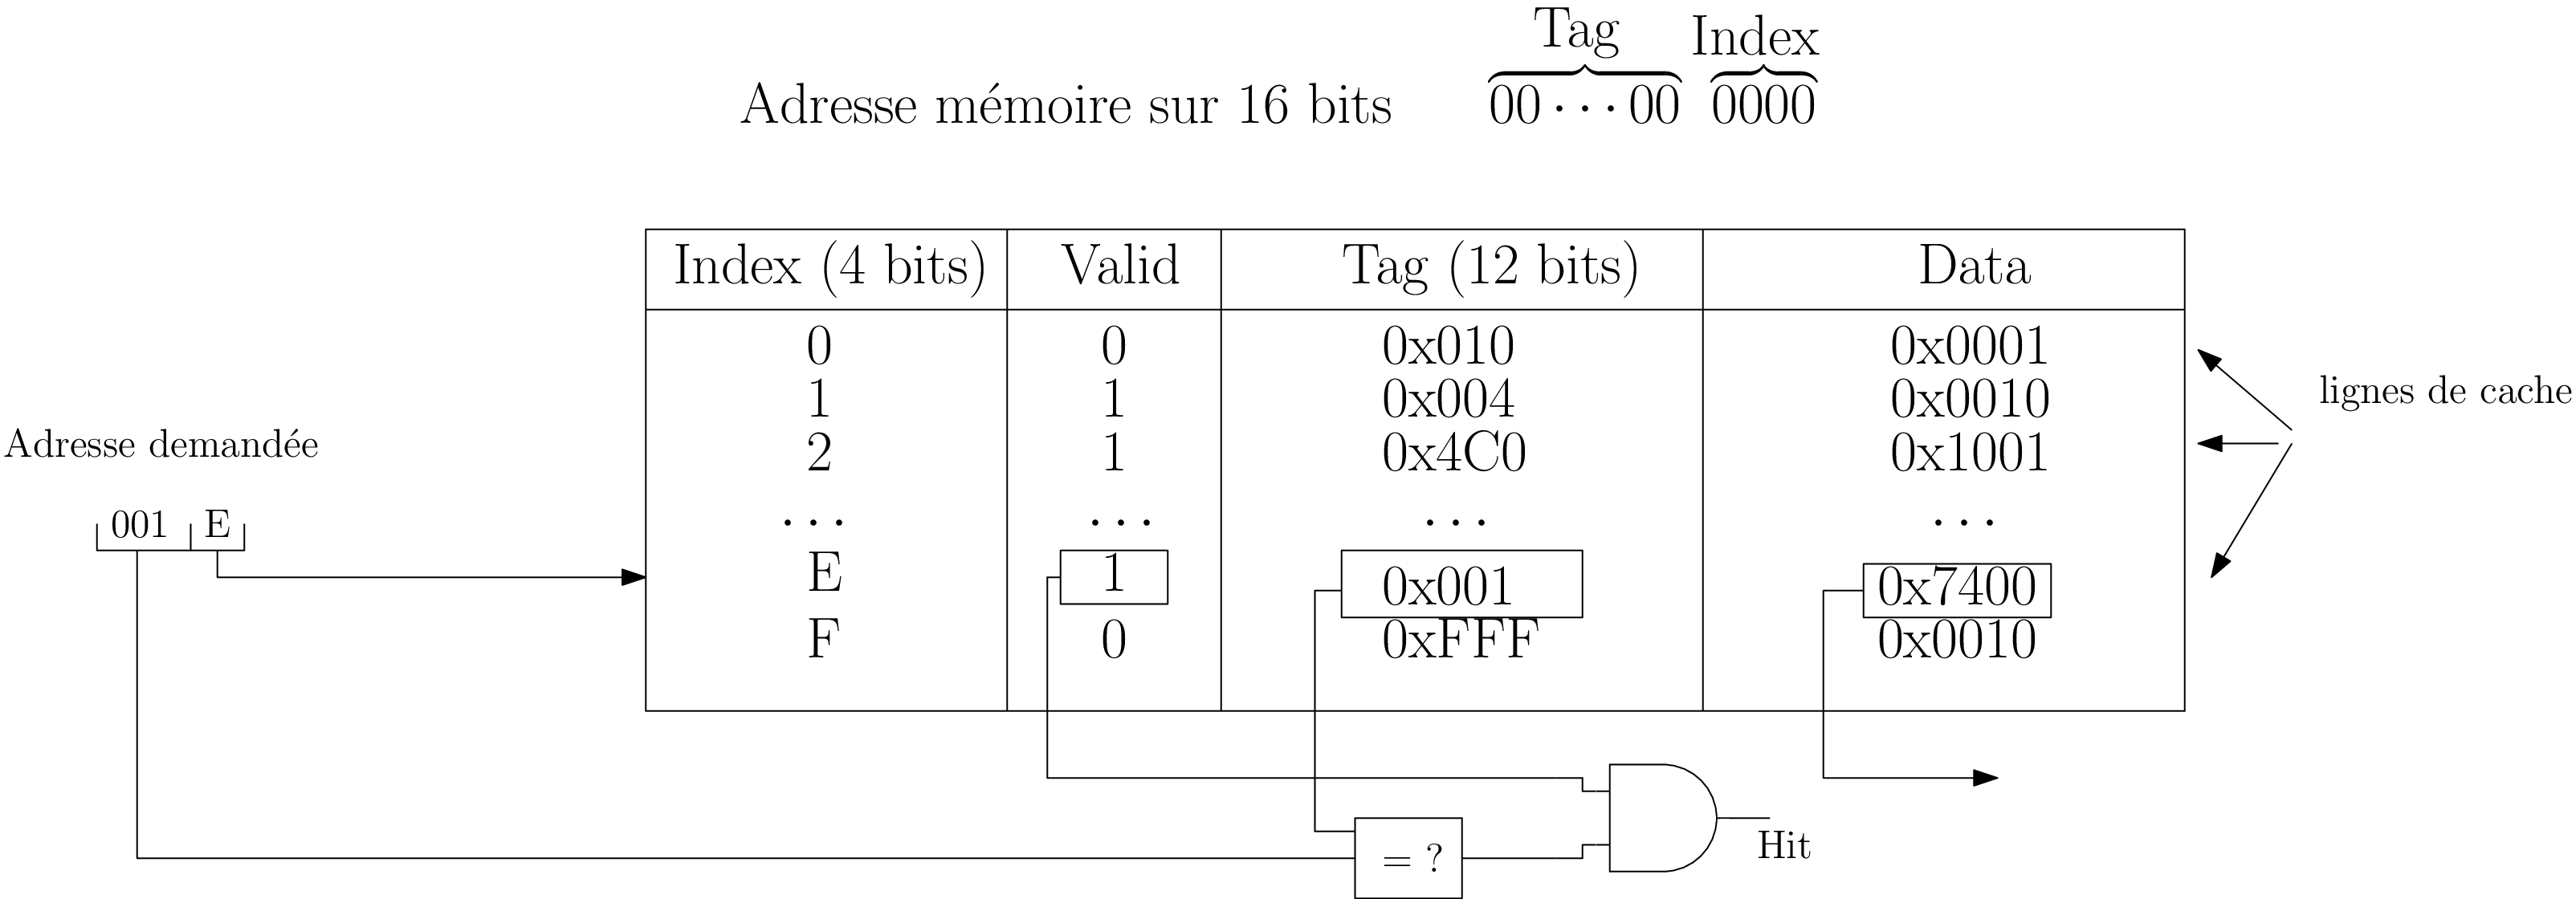
RAM[Adr] → Cache[Adr₃Adr₂Adr₁Adr₀]
pourquoi les bits de poids faibles comme index ? 2 adresses proches ne doivent pas viser la même ligne de cache
Réalisations matérielles d’un cache
Cache à correspondance directe par bloc
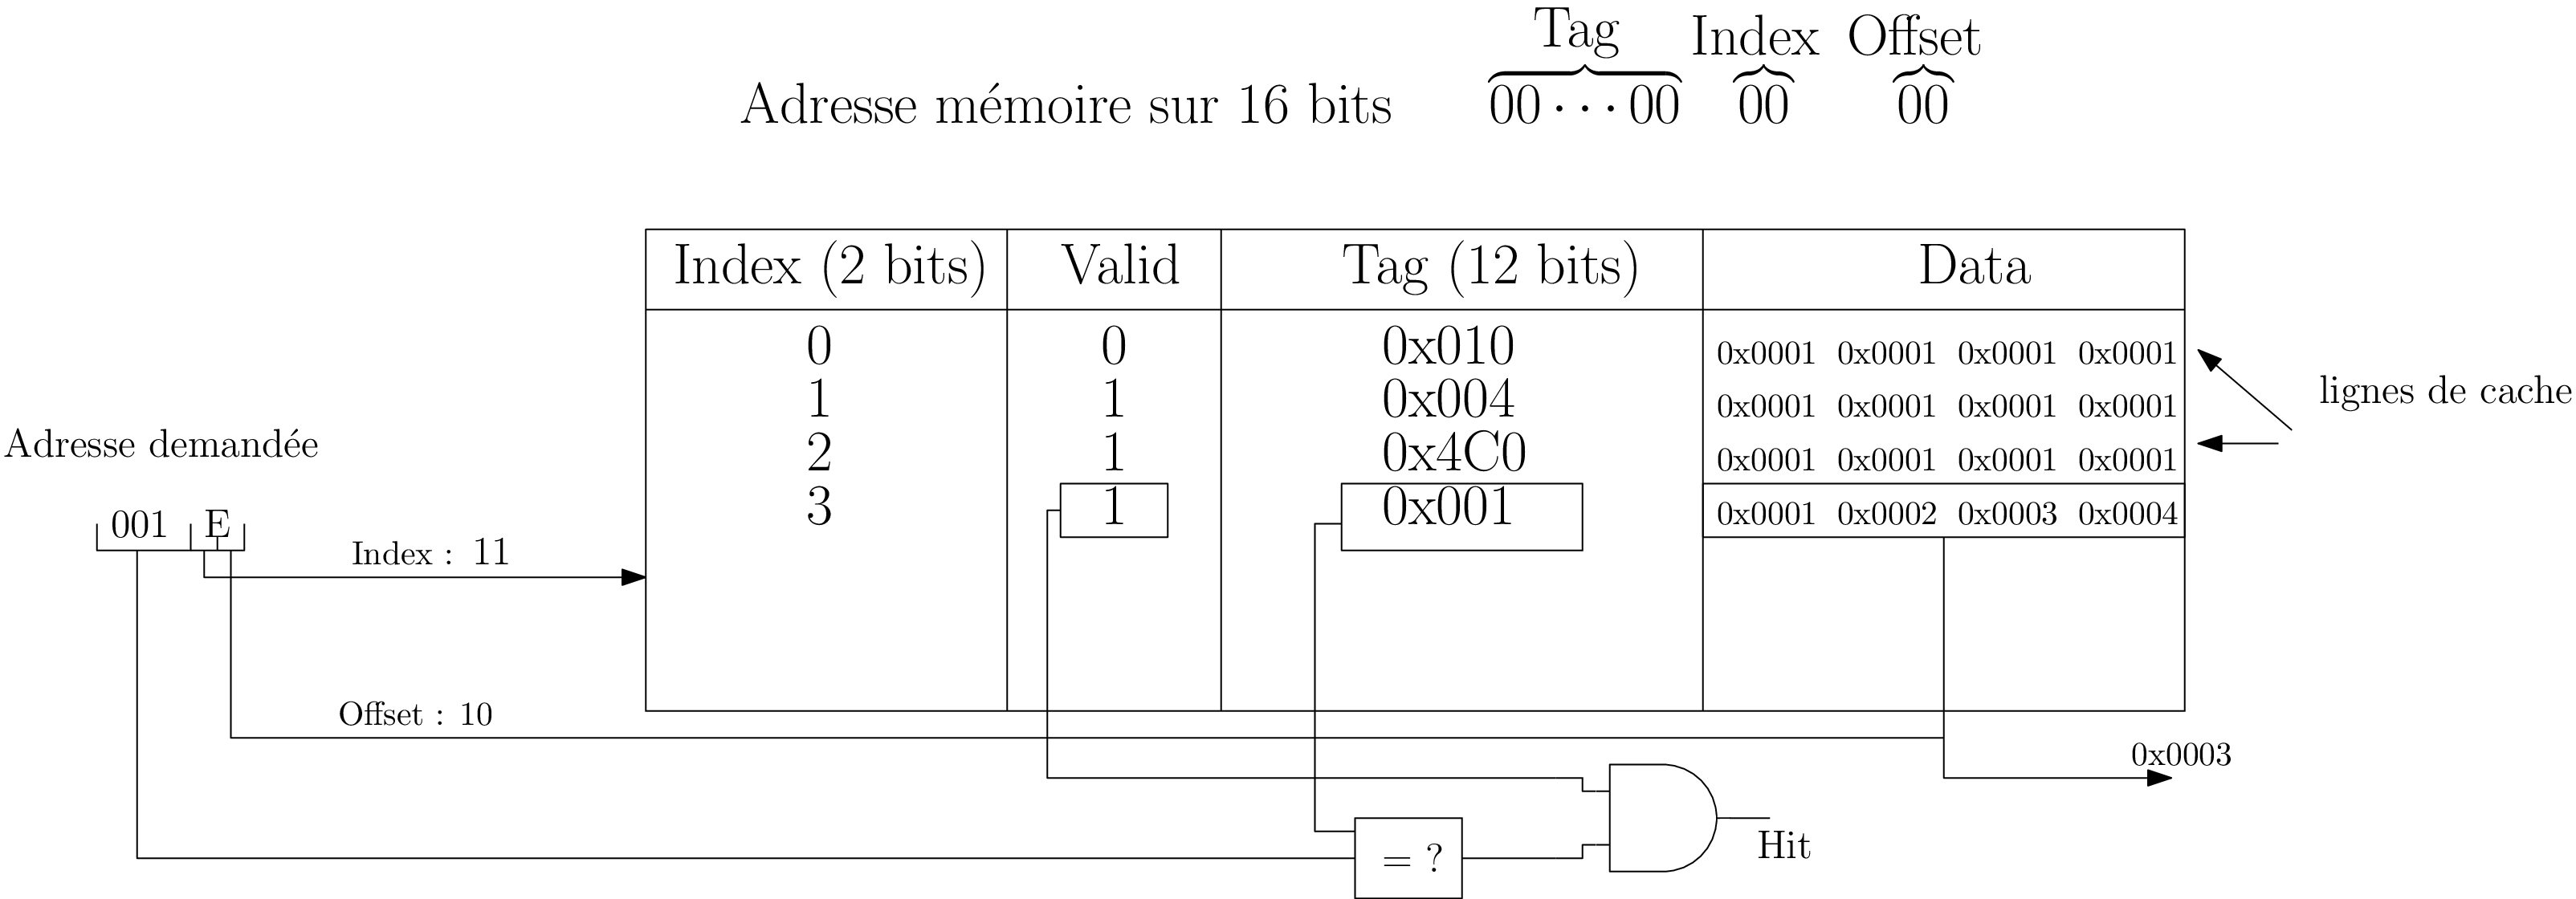
Un bloc : \(2^{|offset|}\) mots; L’offset sert de bits de sélection d’un multiplexeur par ligne.
On charge directement un bloc de mots consécutifs.
Réalisations matérielles d’un cache
Prenons le contre-pieds : Une donnée peut occuper n’importe quelle ligne de cache.
Cache associatif
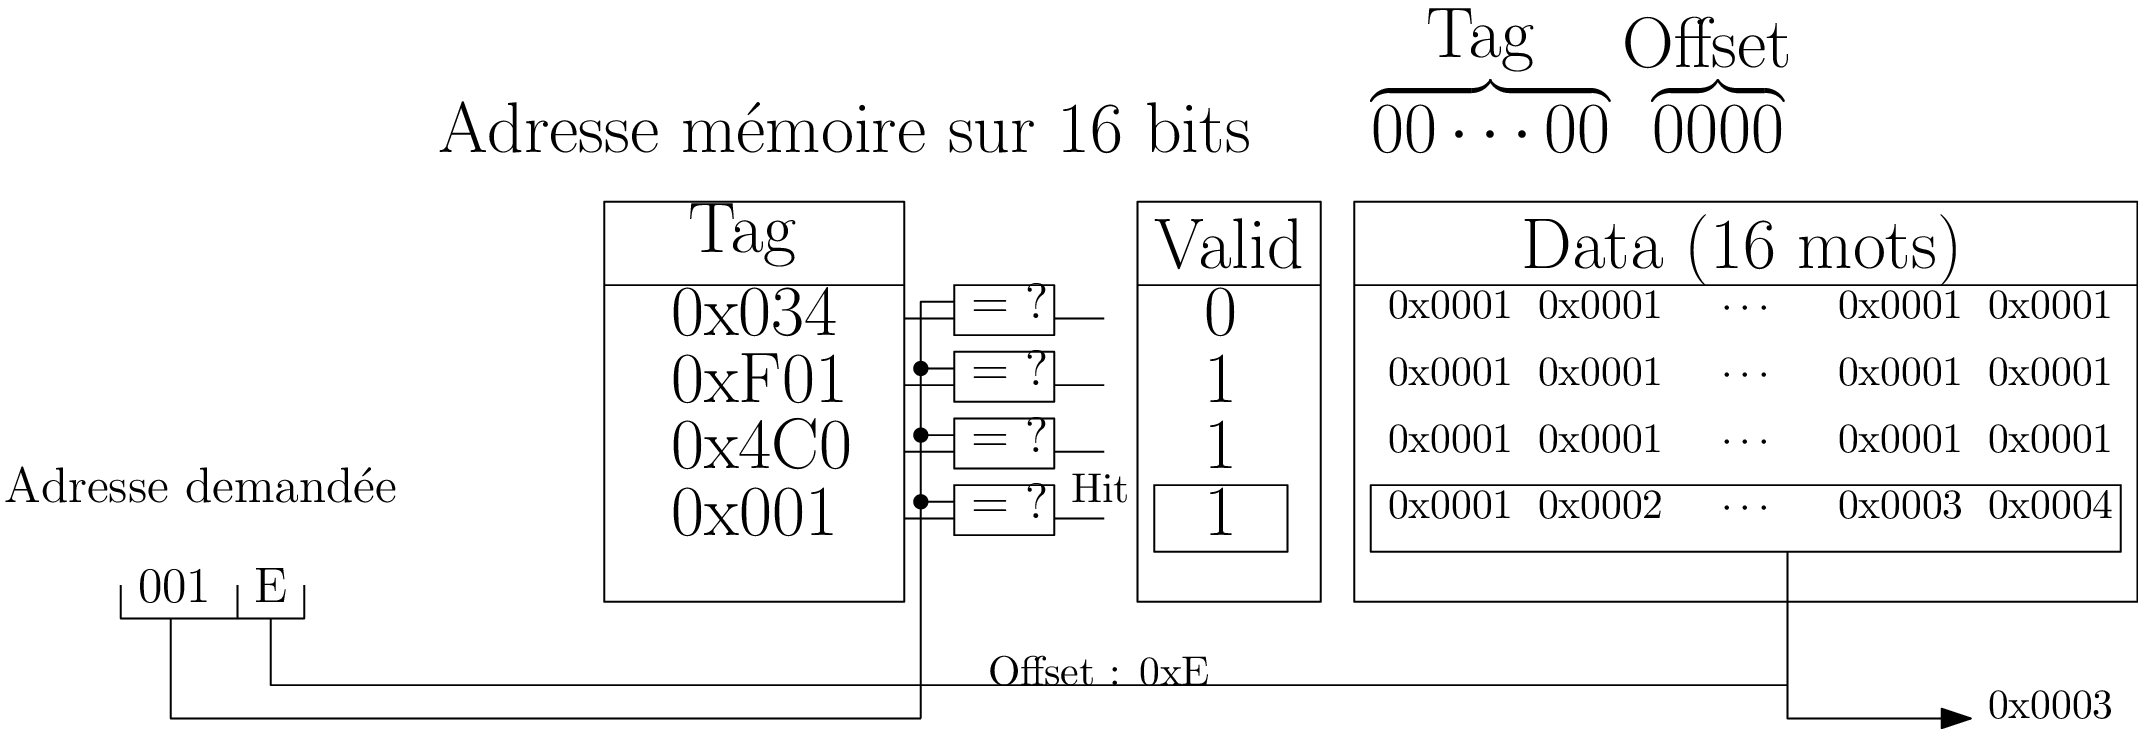
Lourd matériellement. Politique de remplaçement ? e.g. Least Recently Used
Réalisations matérielles d’un cache
Compromis entre le cache direct et le cache associatif : le cache associatif à \(n\) voies
Cache associatif à n entrées
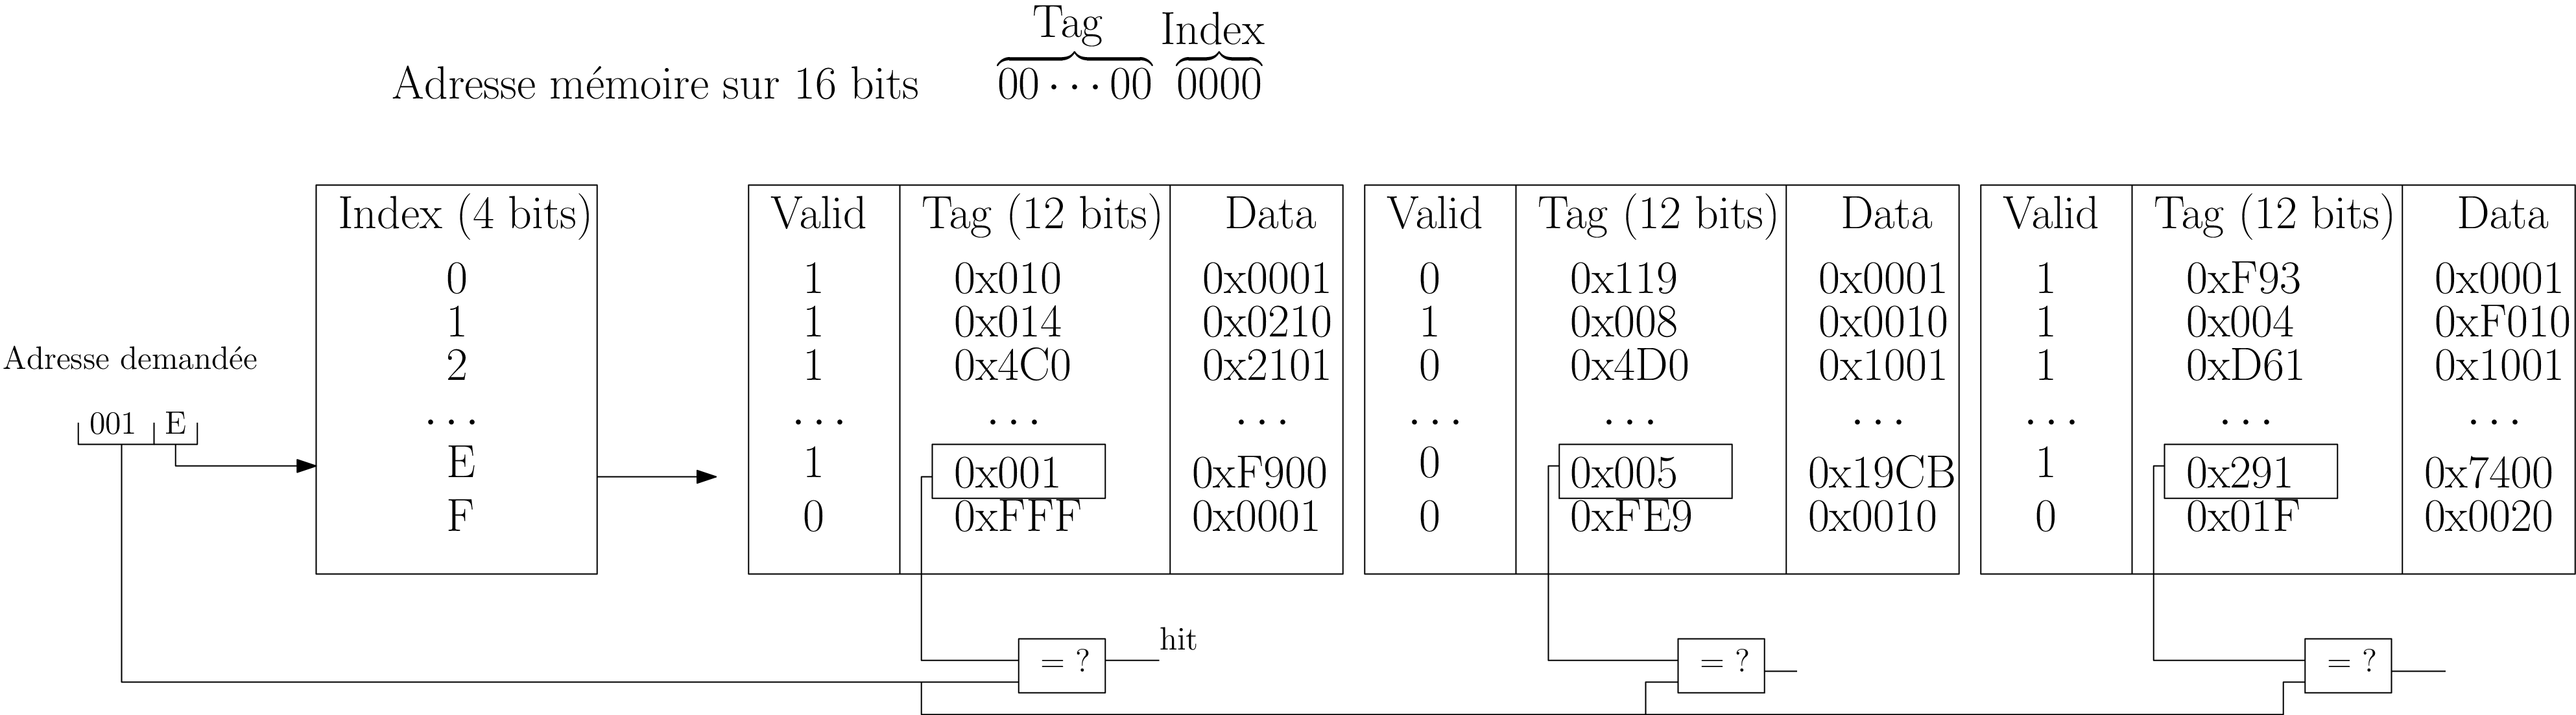
Indexable comme les caches directs, cache[index] étant associatif
Cohérence cache/mémoire centrale
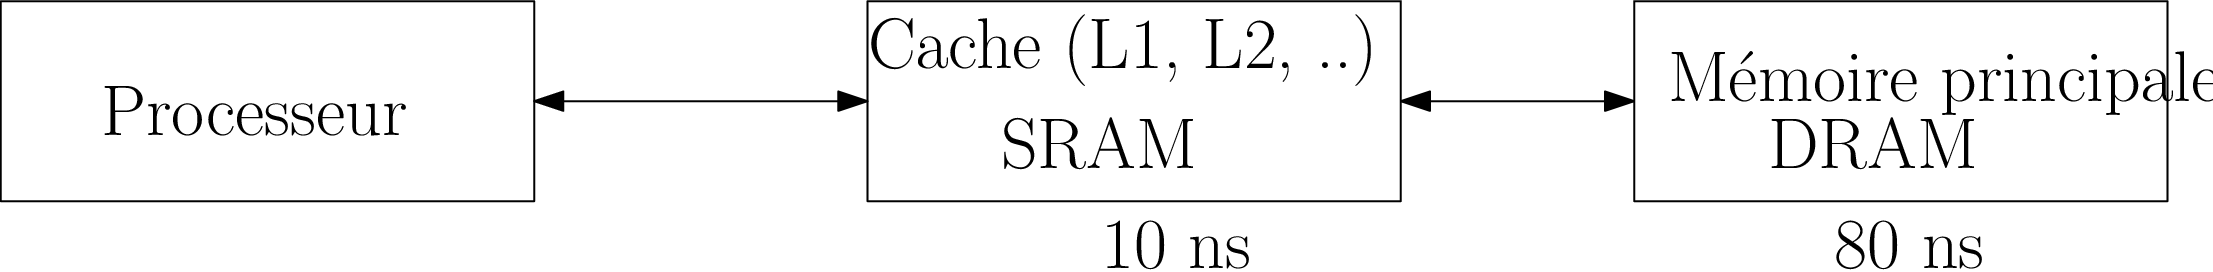
Problème
Une donnée d’une même adresse peut être à la fois en cache, mémoire centrale, voir même sur le disque (e.g. swap)
Politiques d’écriture
- Write through : propagation immédiate d’une modification vers la mémoire principale
- Write back : écriture différée; écriture au remplacement (dirty bit)
Les périphériques d’entrée/sortie
Les périphériques d’entrée/sortie
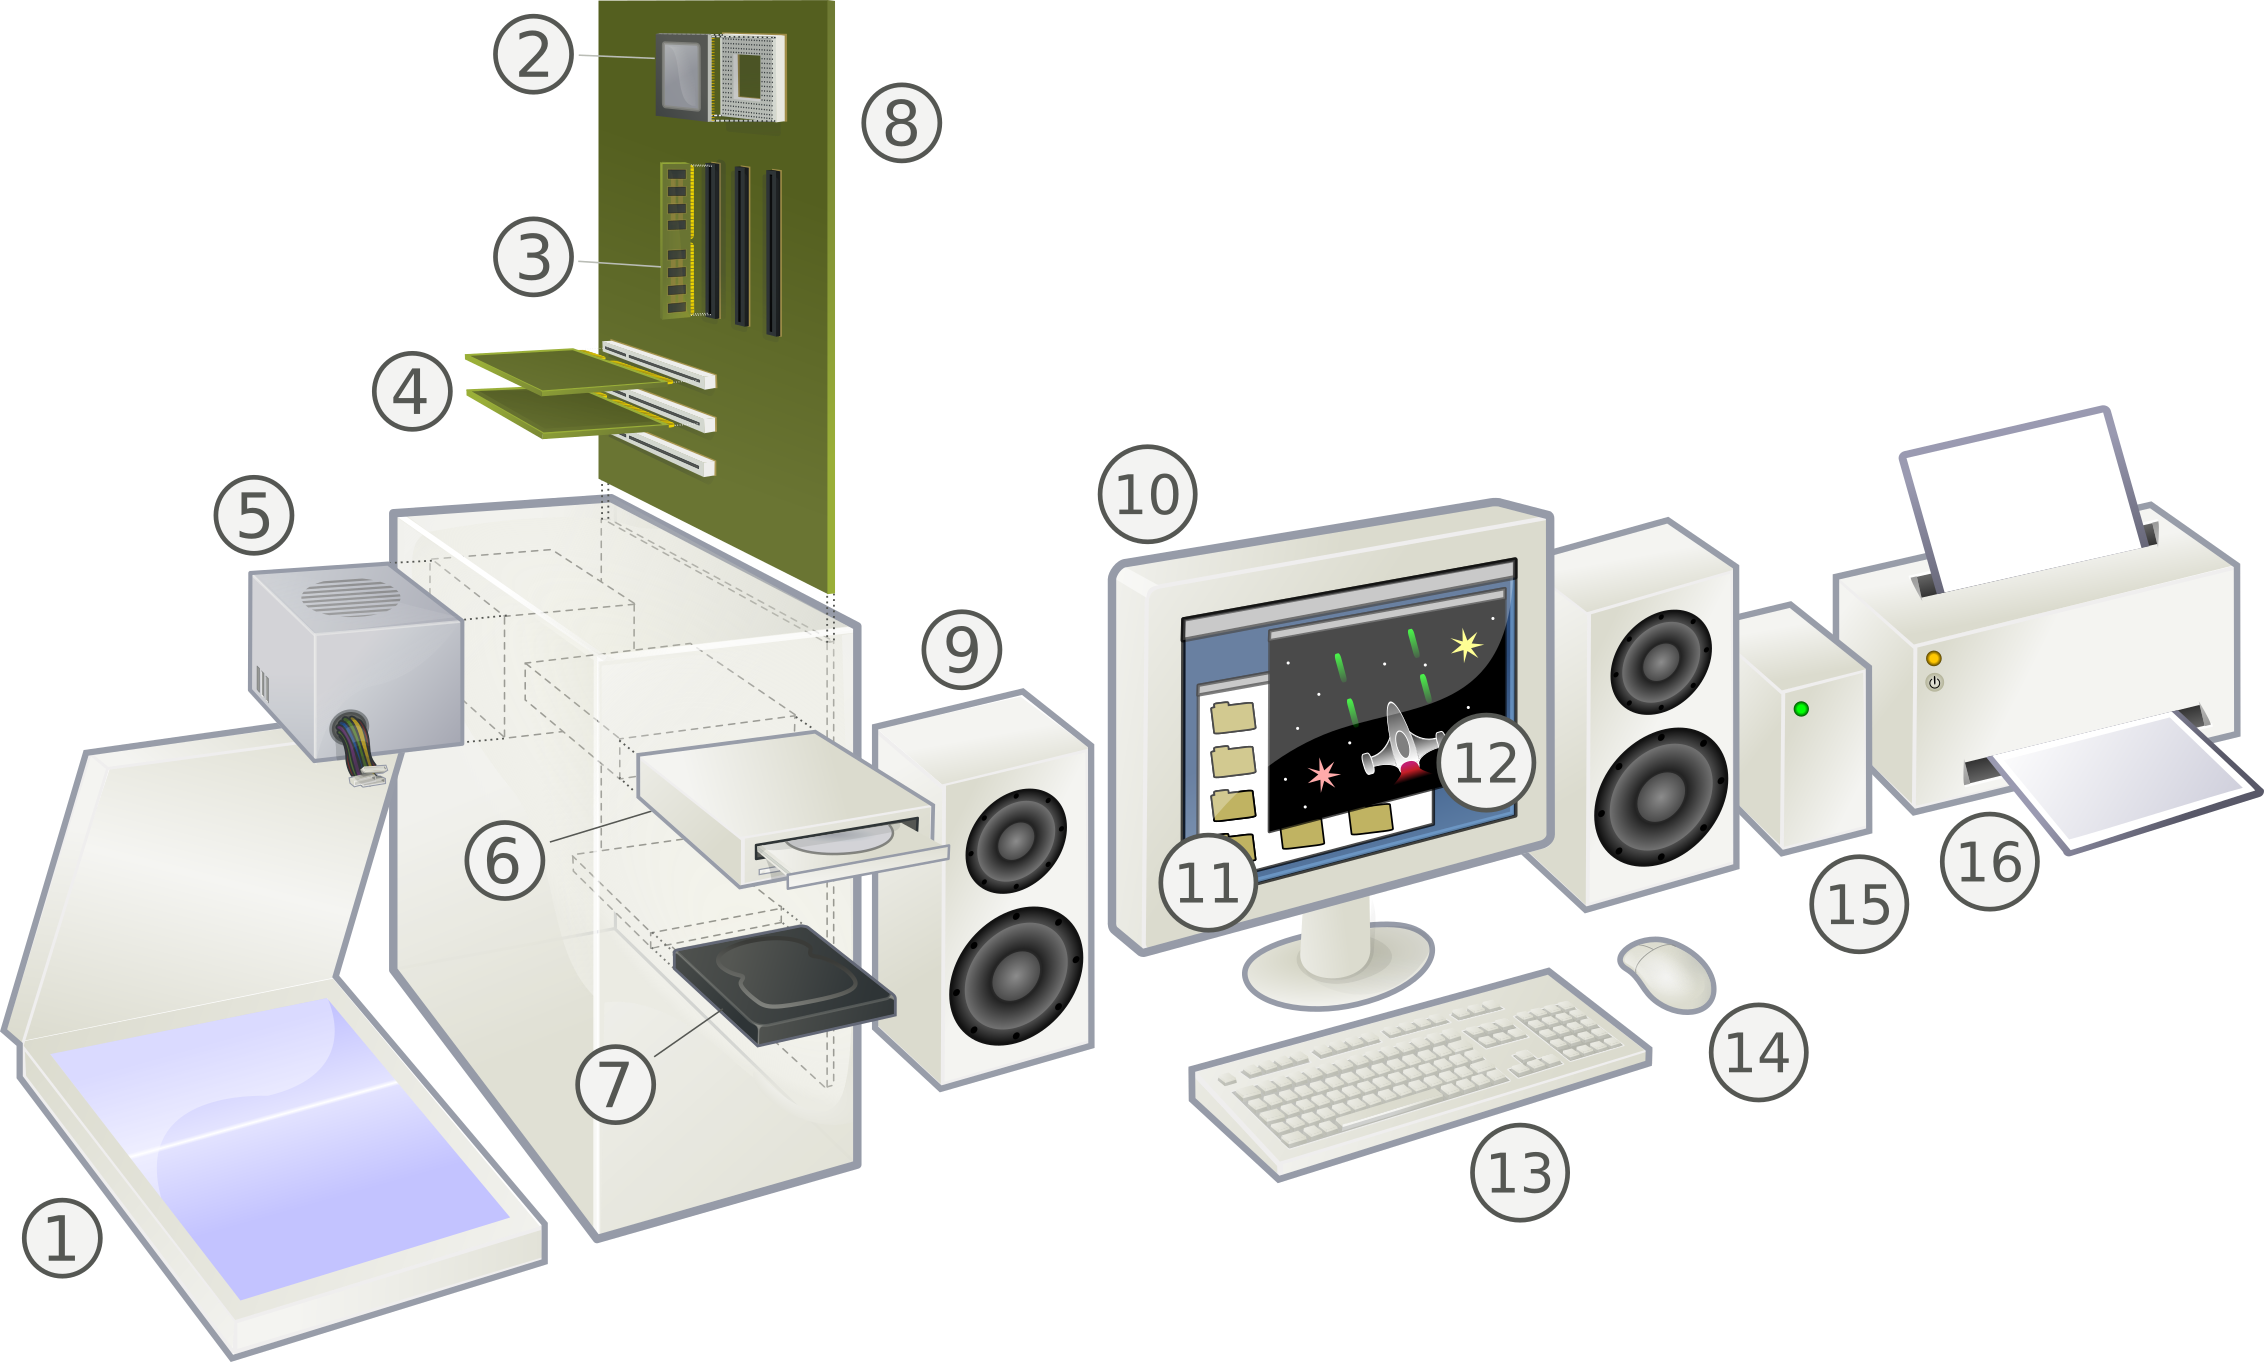
Structure d’un périphérique
Au périphérique est associé un contrôleur (e.g. contrôleur disque) qui possède :
- des registres
- des machines à état
- …
Le périphérique est couplé aux bus d’adresses, données, contrôle.
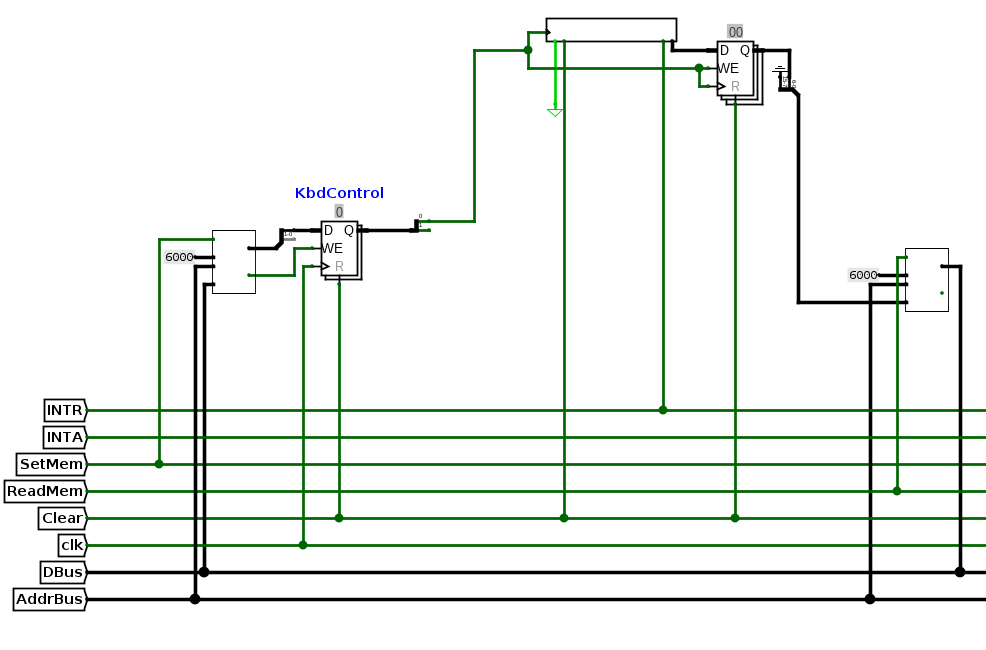
Exemple d’un contrôleur clavier (e.g. Intel 8042)
Contrôleur clavier minimaliste sur notre architecture :
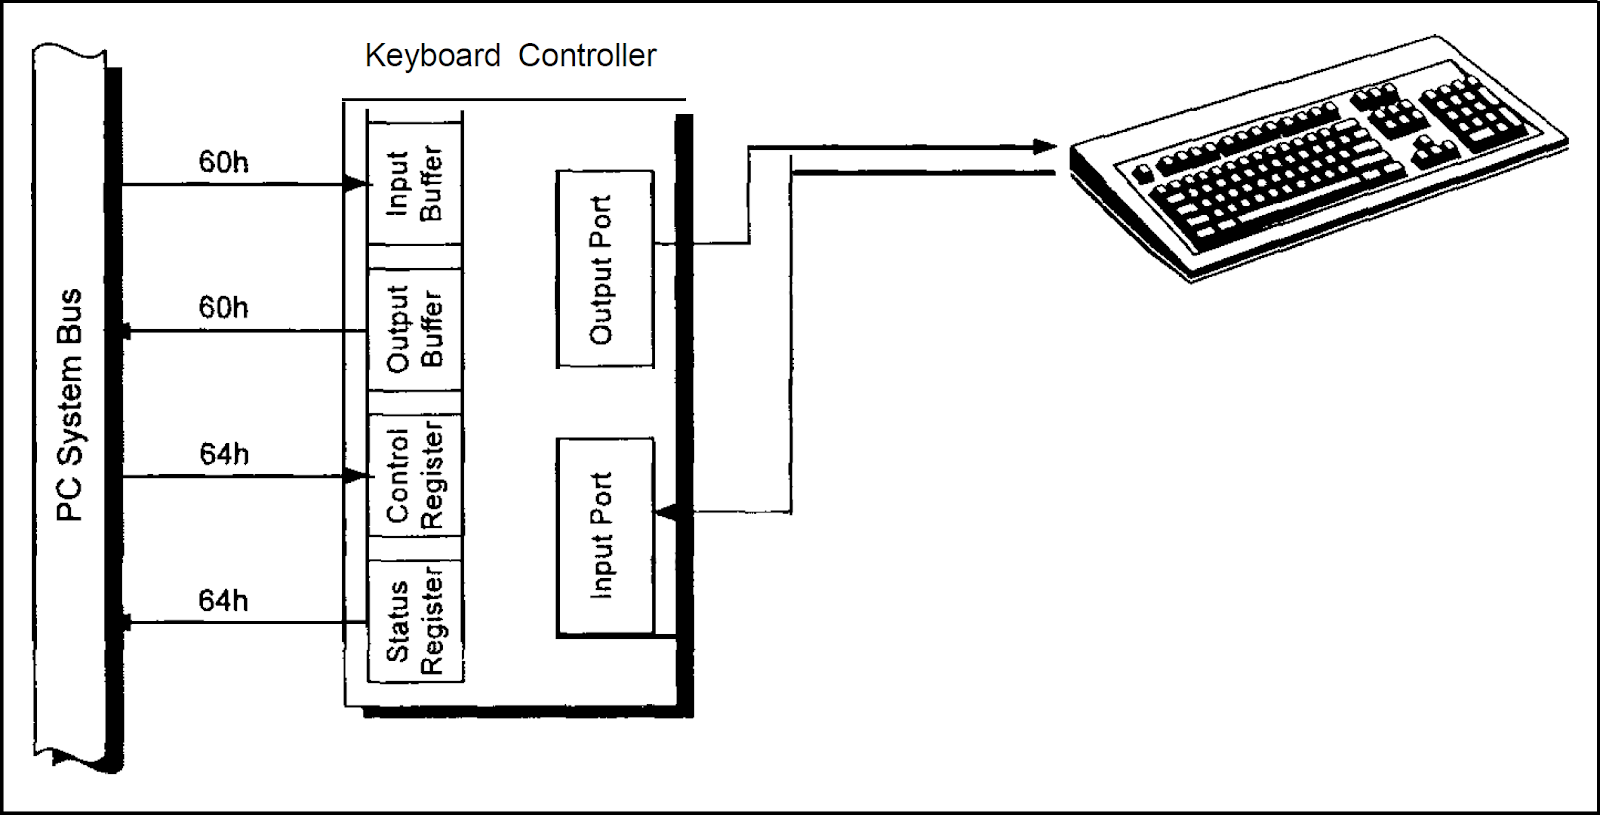
Bus : Interconnexion des périphériques et du chemin de données
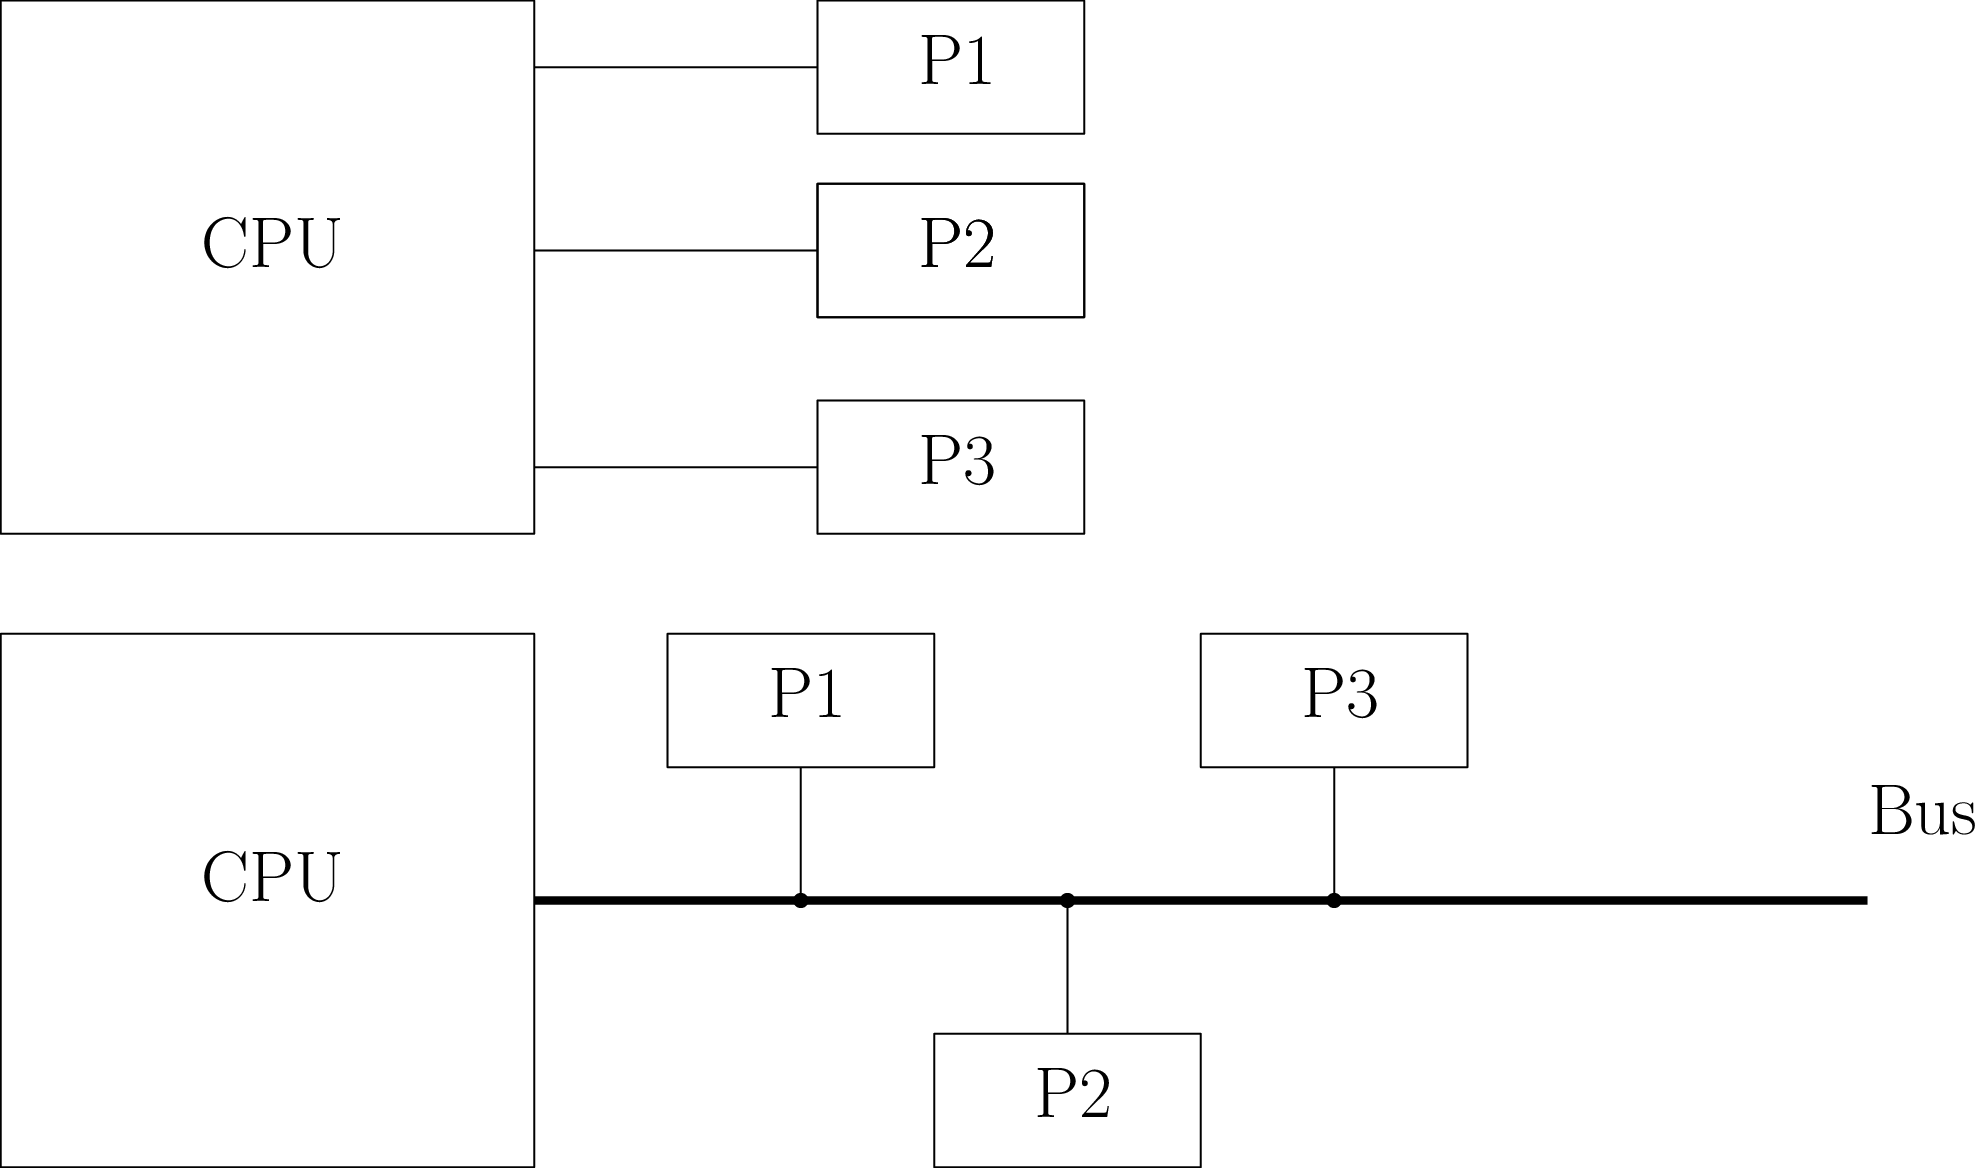
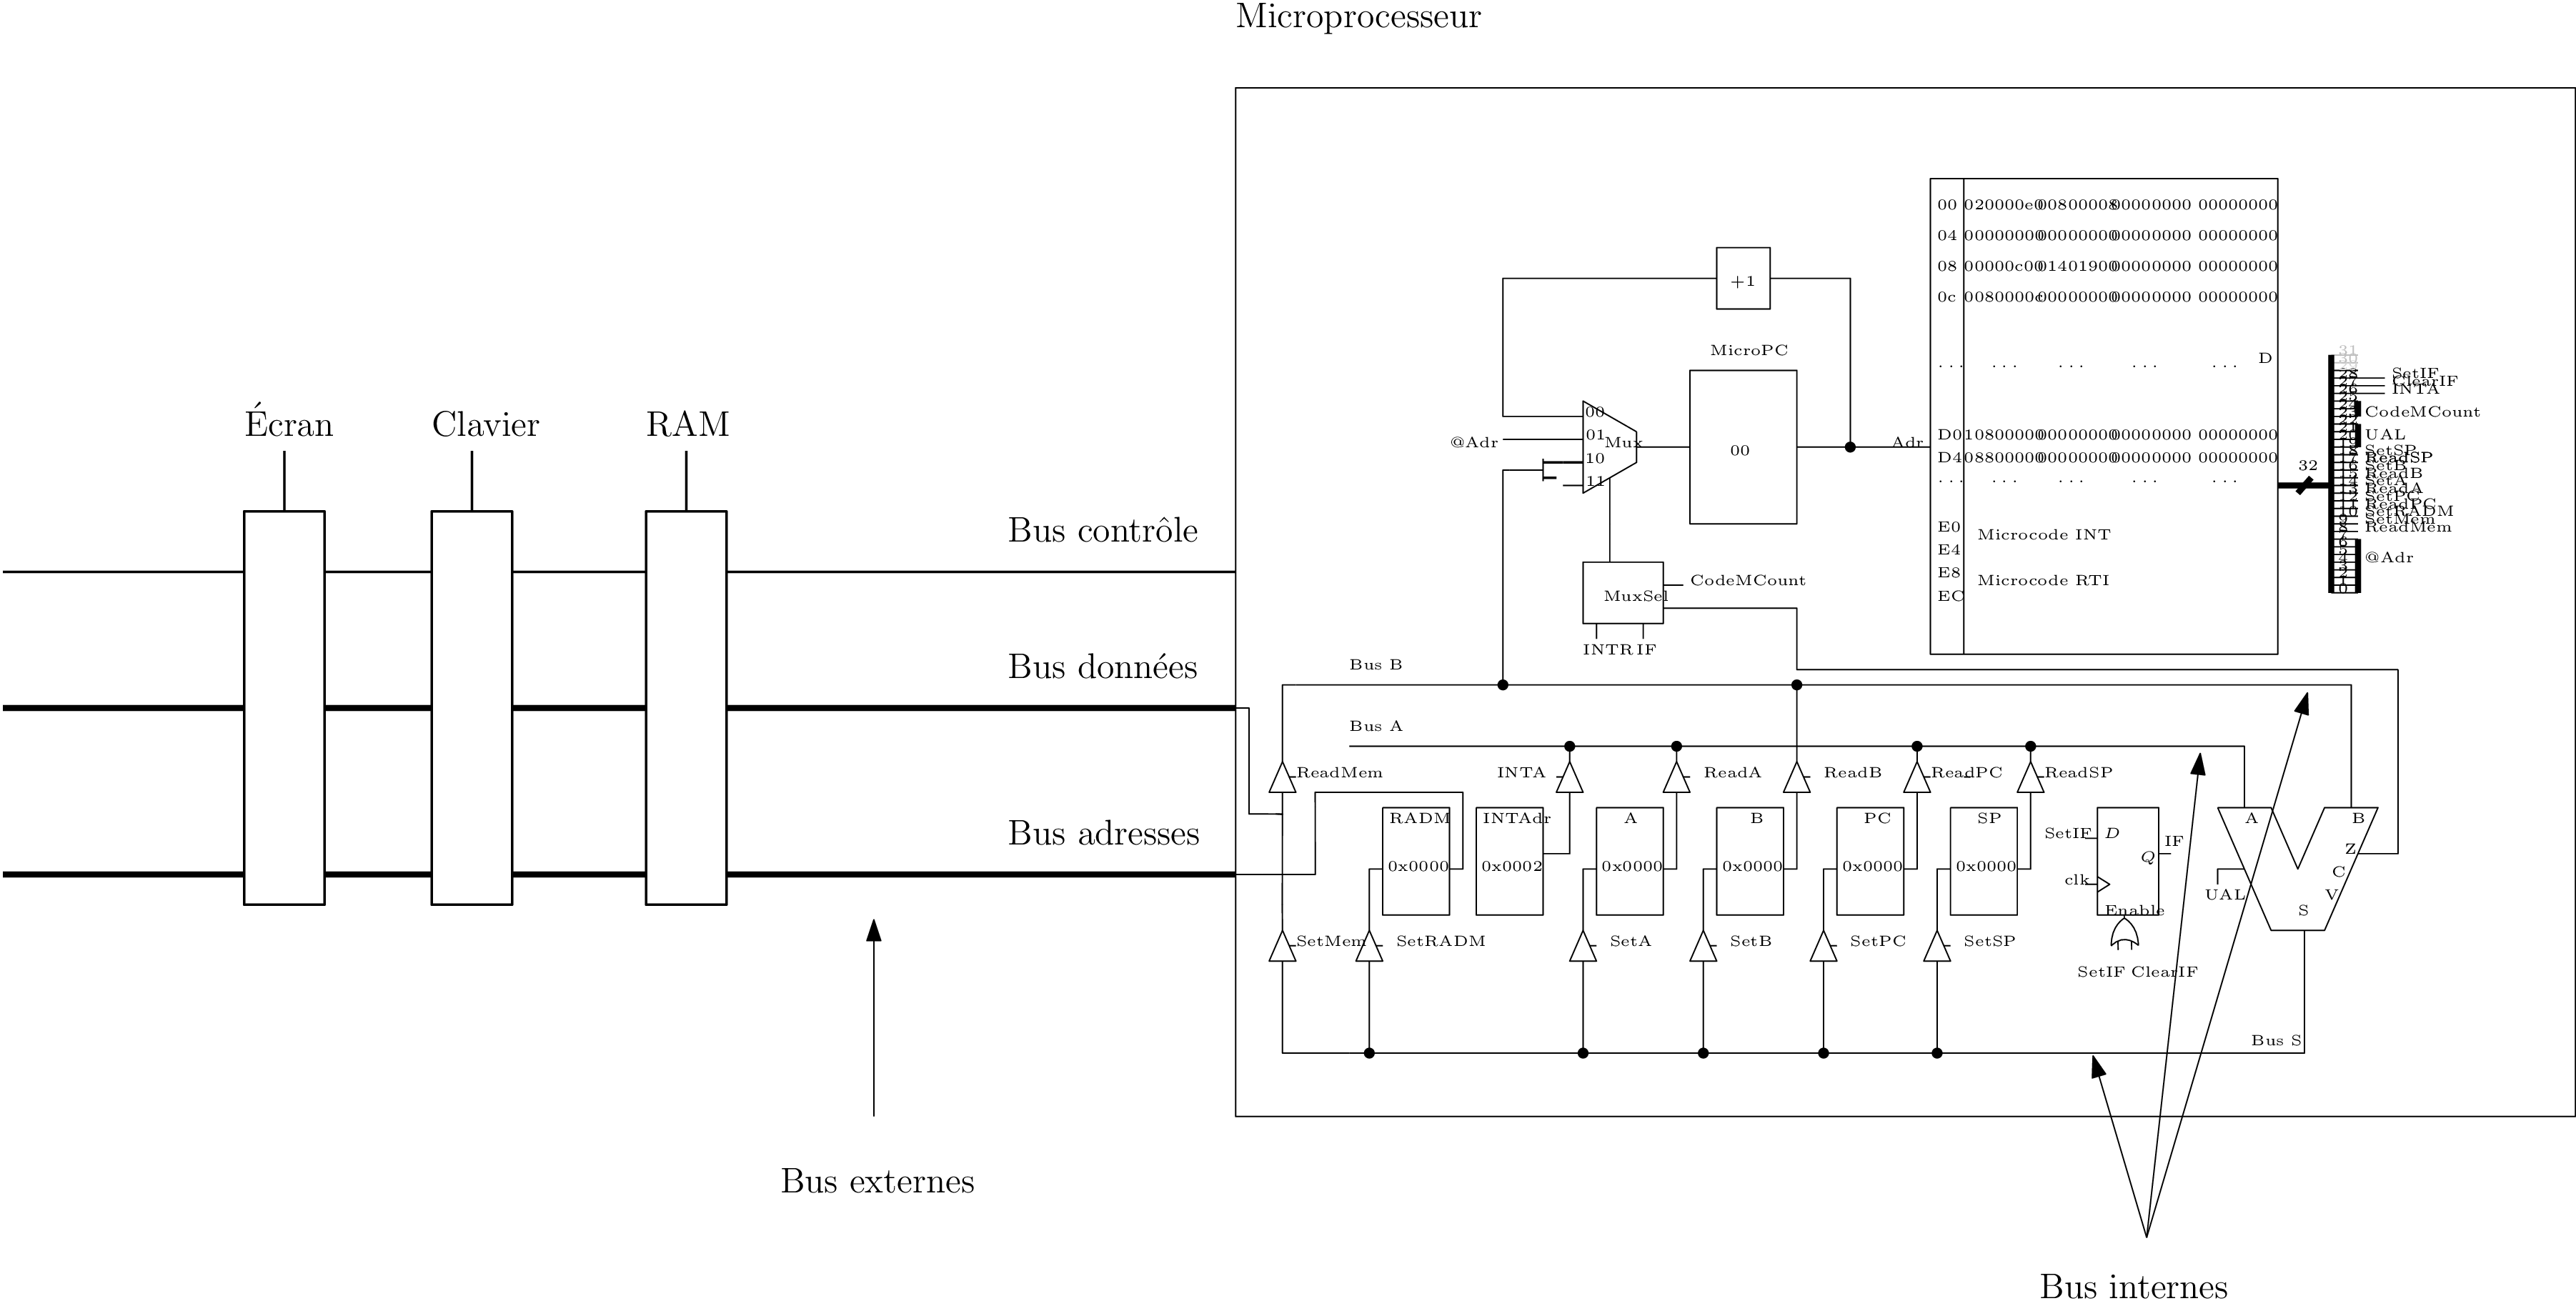
Interconnexion des périphériques et du chemin de données
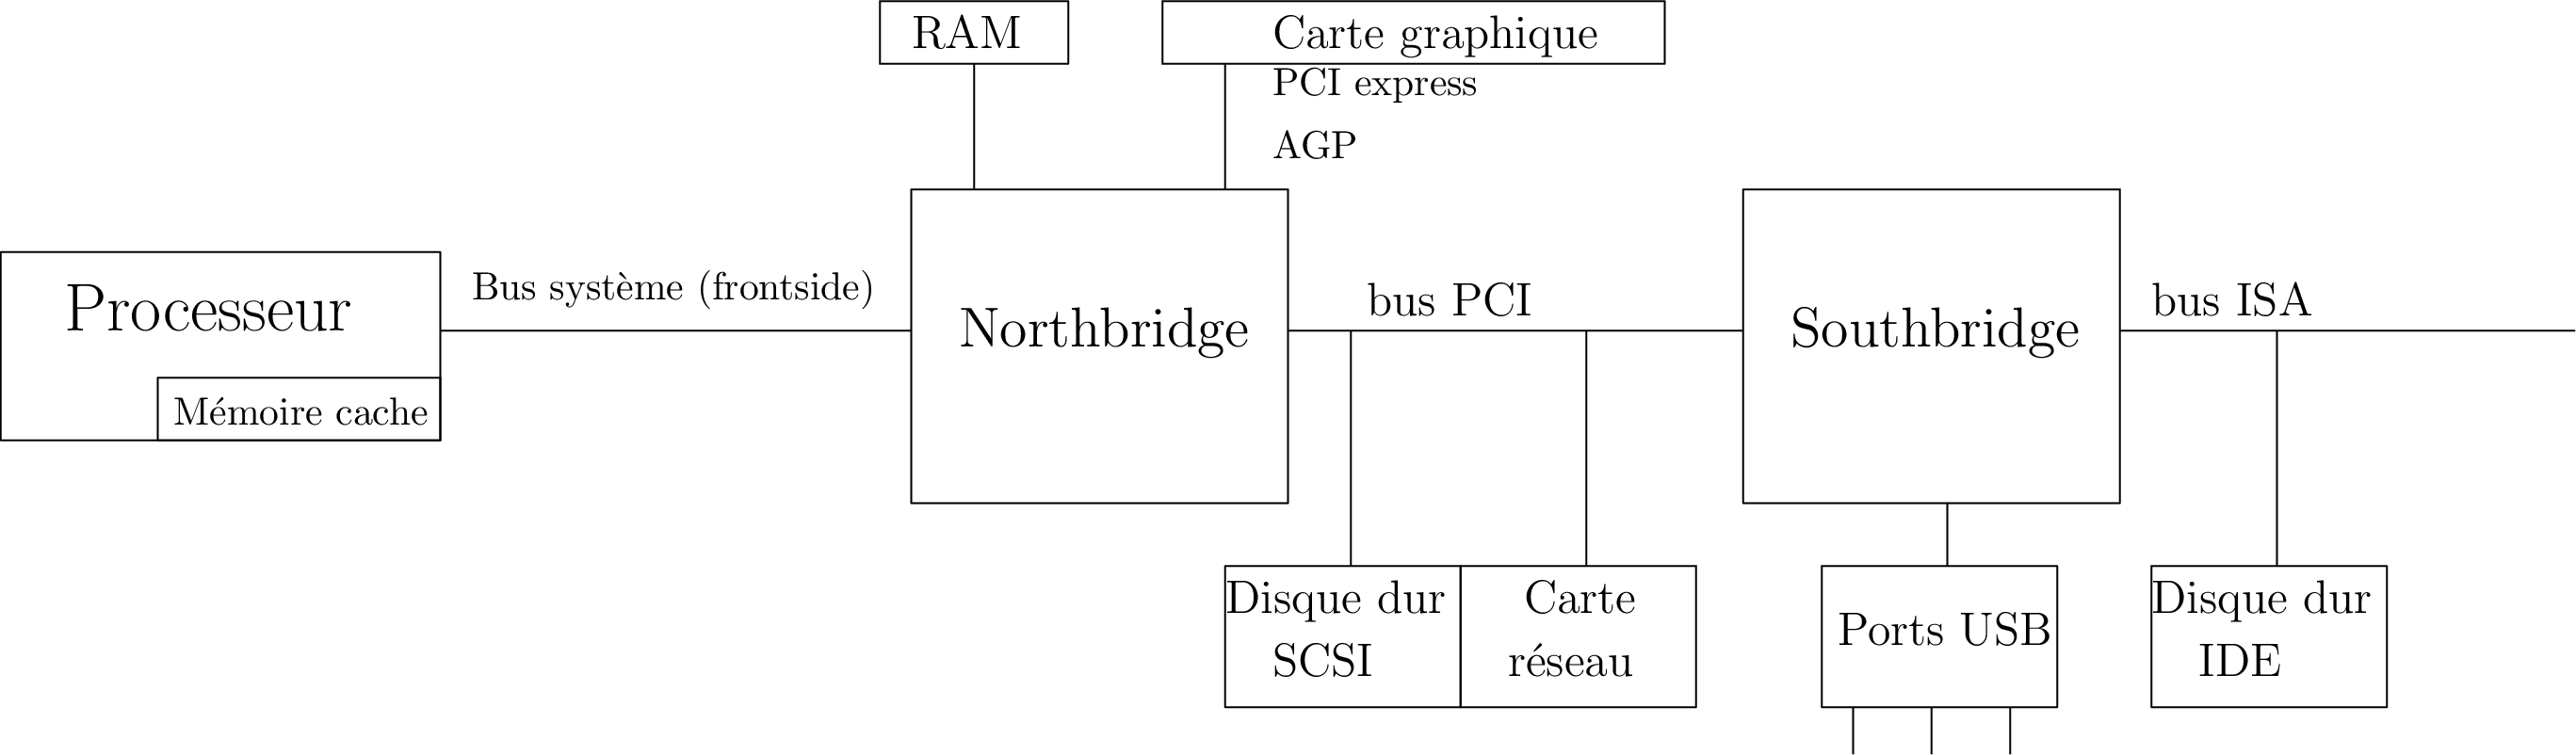
Les bus
| Bus | Largeur (bits) | Clk (MHz) | Débit (Mo/s) | Année |
|---|---|---|---|---|
| ISA 16 | 16 | 8.33 | 15.9 | 1984 |
| PCI 32 | 32 | 33 | 125 | 1993 |
| AGP | 32 | 66 | 250 | 1997 |
| PCI-E 3 (x16) | 16 | 8000 | 16000 | 2011 |
Bus parallèles (échange de mots, large mais court) / Bus série (bit à bit, e.g. USB)
Comment contacter les entrées/sorties ?
Il faut pouvoir contacter les registres du contrôleur du périphérique.
E/S mappées en mémoire
- comme pour un accès mémoire LDA, STA
- avec des adresses réservées, ciblant les périphériques
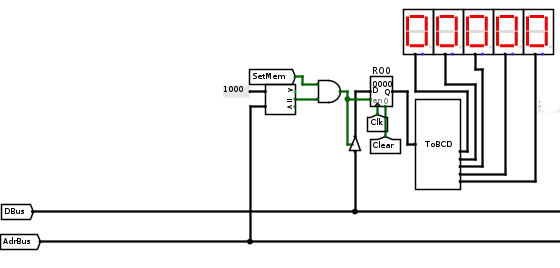
Autre solution : pas de bus d’adresse; placer dans le message un identifiant du destinataire.
Protocoles d’échange : e.g. lecture mémoire
Echange synchrone
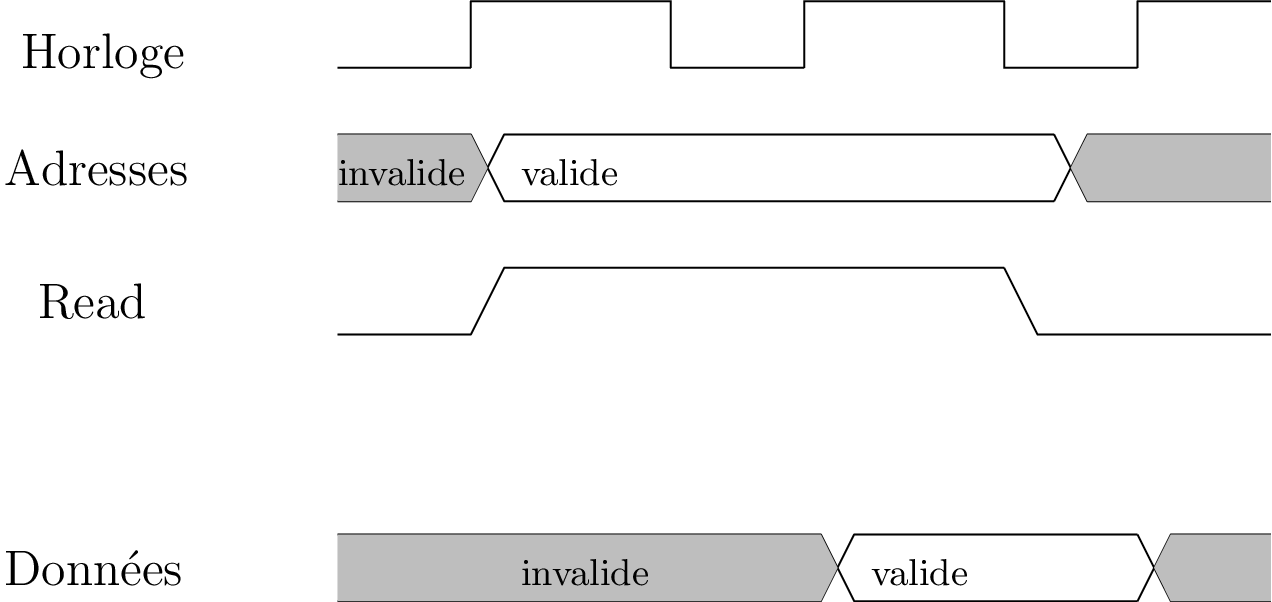
Les données doivent être disponibles au prochain front montant d’horloge.
\(\Rightarrow\) Fréquence d’horloge : ajustée au périphérique le plus lent
Protocoles d’échange : e.g. lecture mémoire
Echange “semi” synchrone
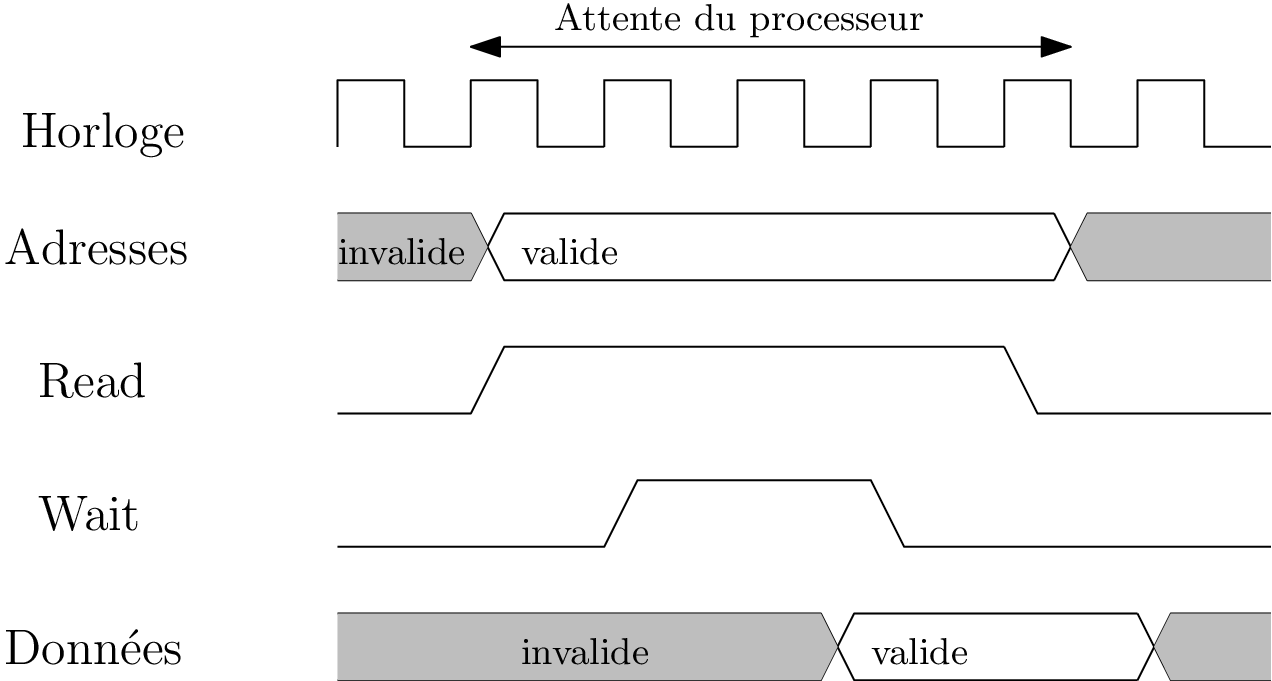
Un signal permet d’indiquer la présence de la donnée \(\Rightarrow\) le processeur peut vaquer à d’autres occupations.
Protocoles d’échange : e.g. lecture mémoire
Echange asynchrone : Master/Slave
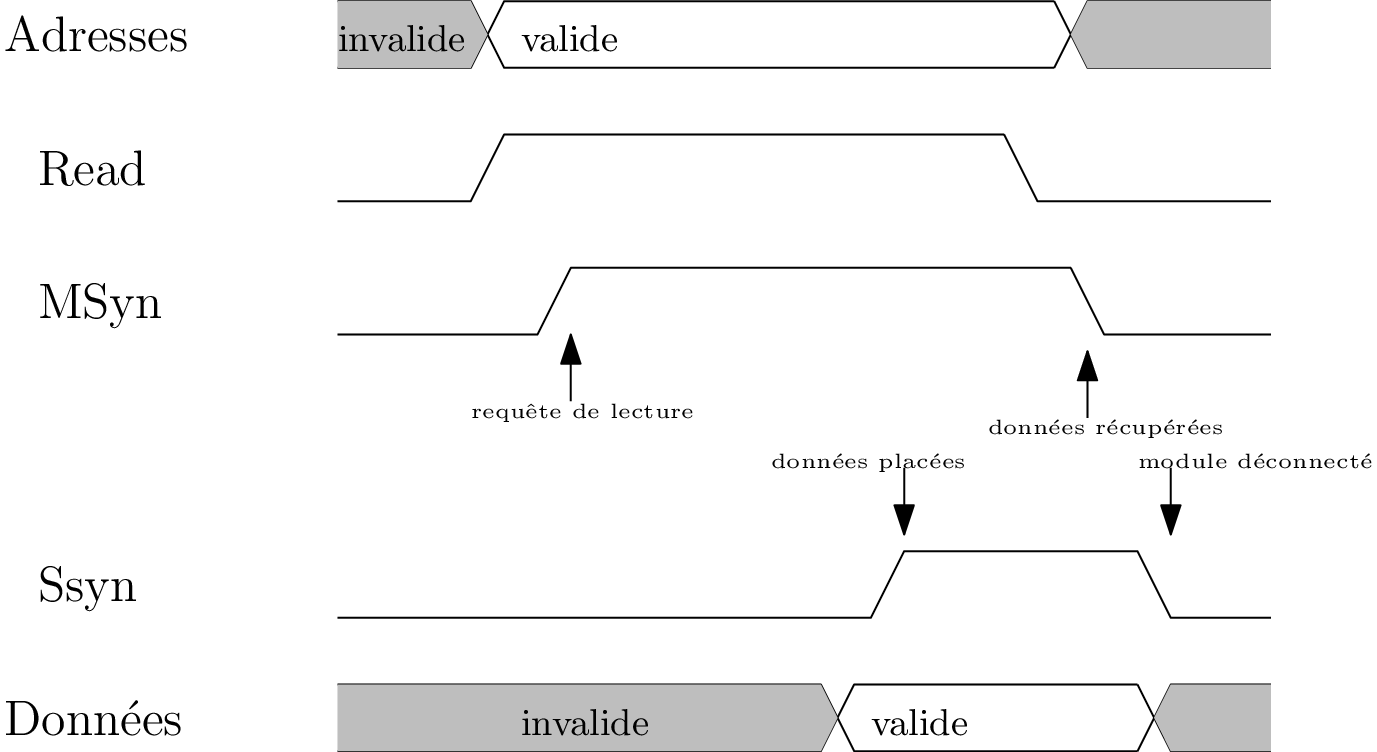
Pas d’horloge mais des signaux d’état : handshaking
Plus réactif mais plus compliqué à mettre en oeuvre.
Modification du chemin de données
On ajoute :
- une ligne de requête d’interruption (INTR - INTerrupt Request) qu’un périphérique peut mettre à l’état haut.
- Registre IF - Interrupt Flag - pour y être sensible ou non.
- des signaux de contrôle SetIF/ClearIF et INTA - INTerrupt Acknowledge
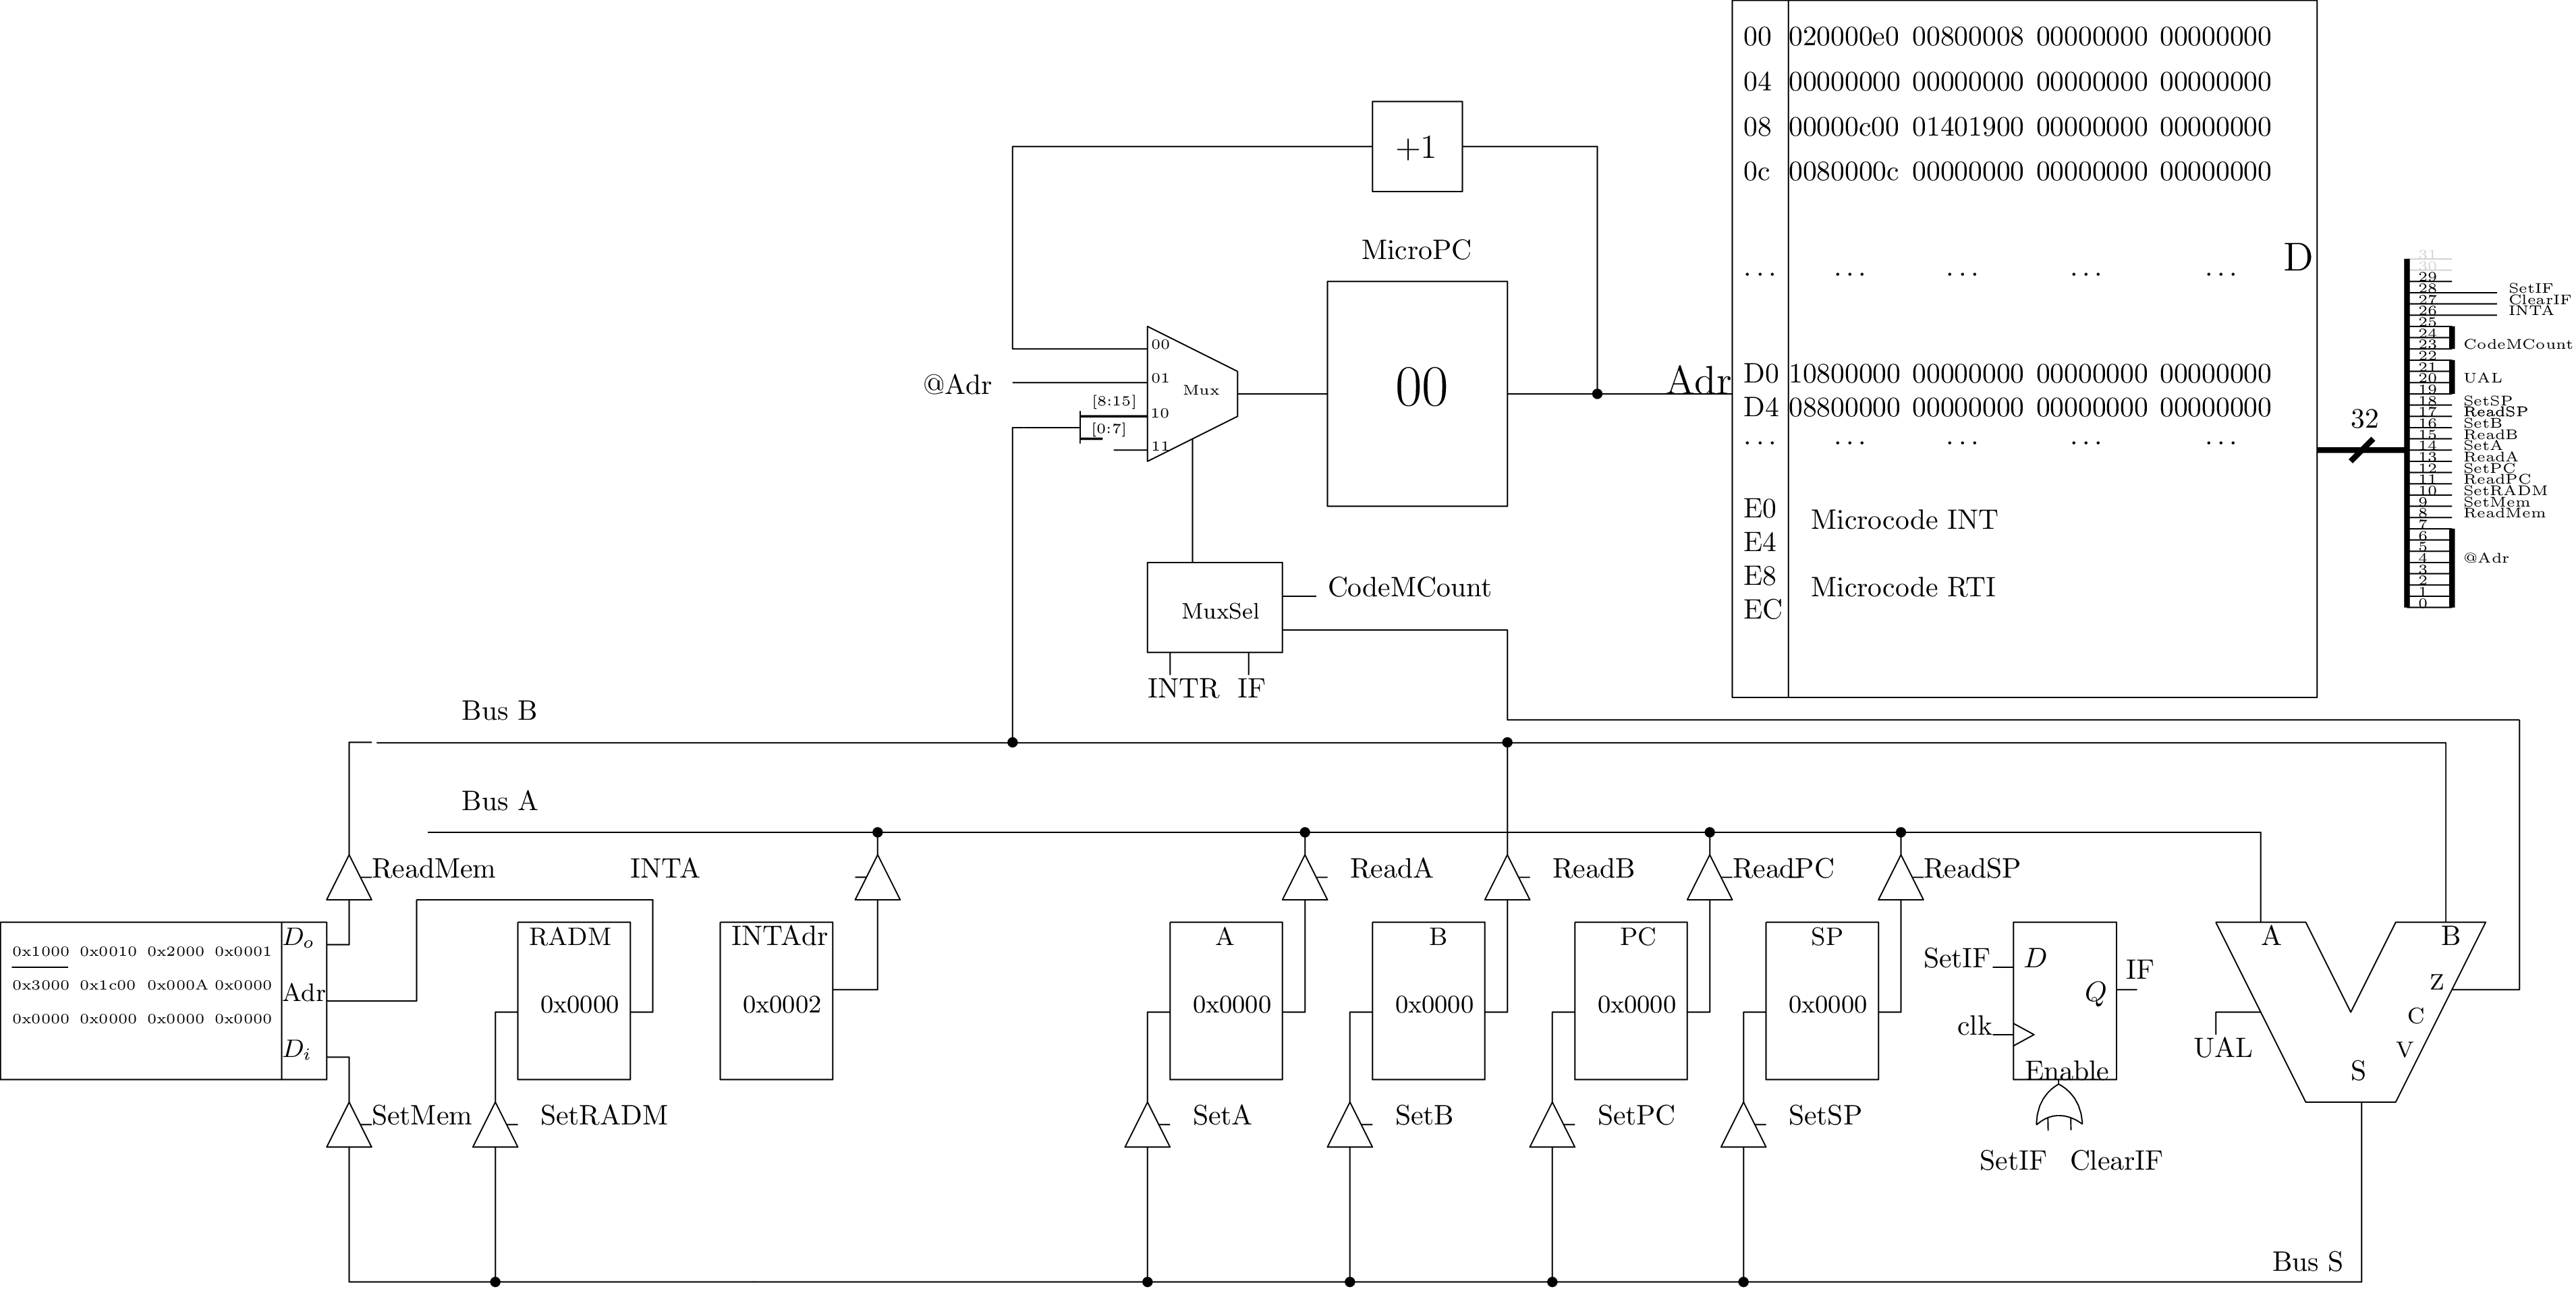
Chez nous : une seule interruption
Pour le moment, avec une seule interruption, l’adresse de la routine d’interruption est codée en dur, dans le registre INTAdr
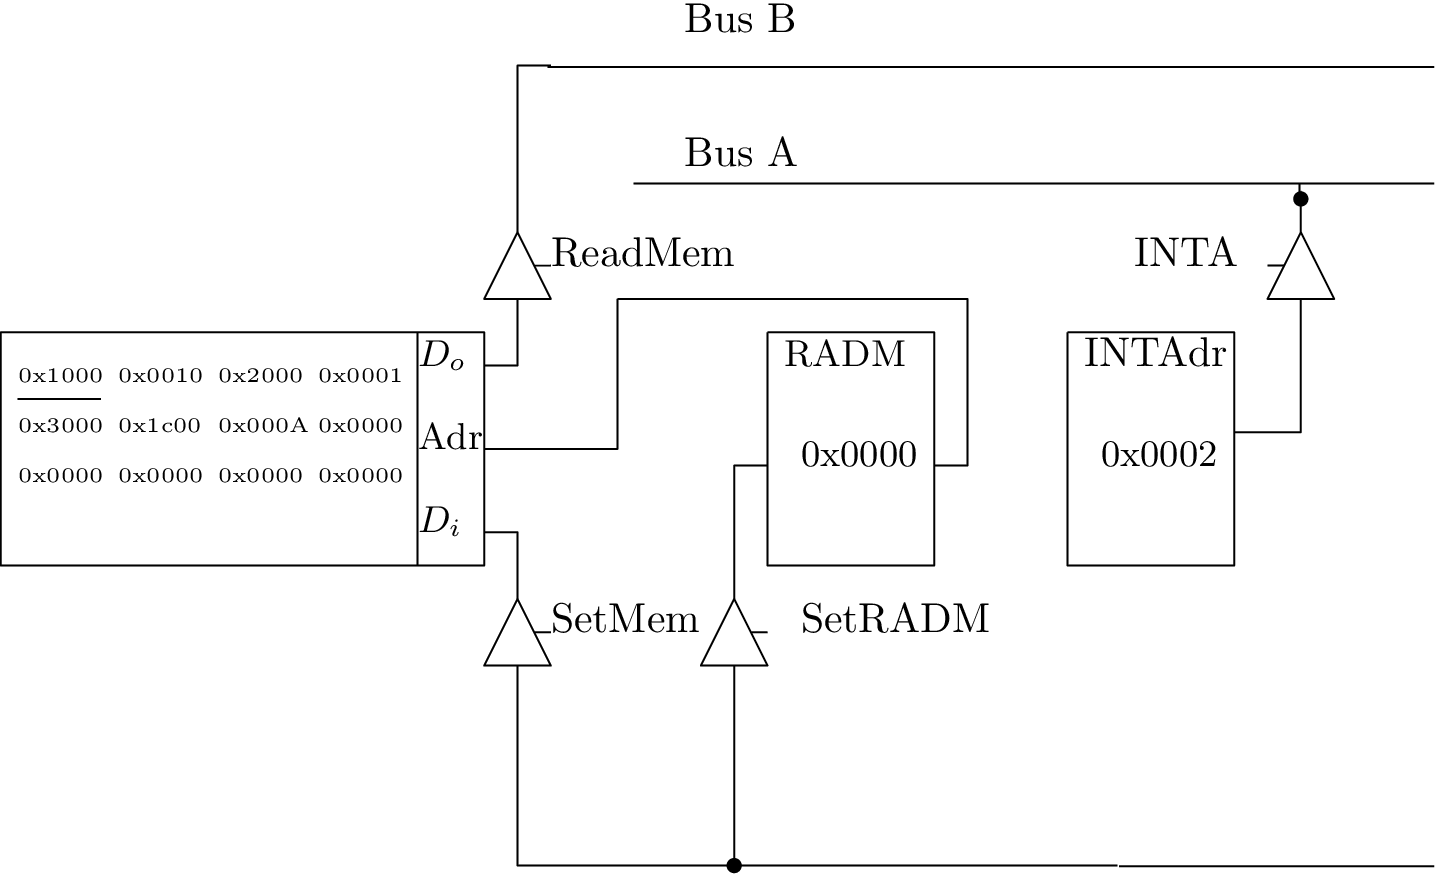
Résumons
- le périphérique lève une requête d’interruption INTR=1,
- le processeur détecte la requête lors du prochain fetch/decode et \(\mu\)-PC se déroute si besoin,
- le processeur sauvegarde l’état courant
- le processuer se branche sur la routine d’interruption (vecteur d’interruption ou interrupt handler) en accusant réception INTA,
- le processeur exécute la routine d’interruption,
- le processeur restaure l’état au RTI.
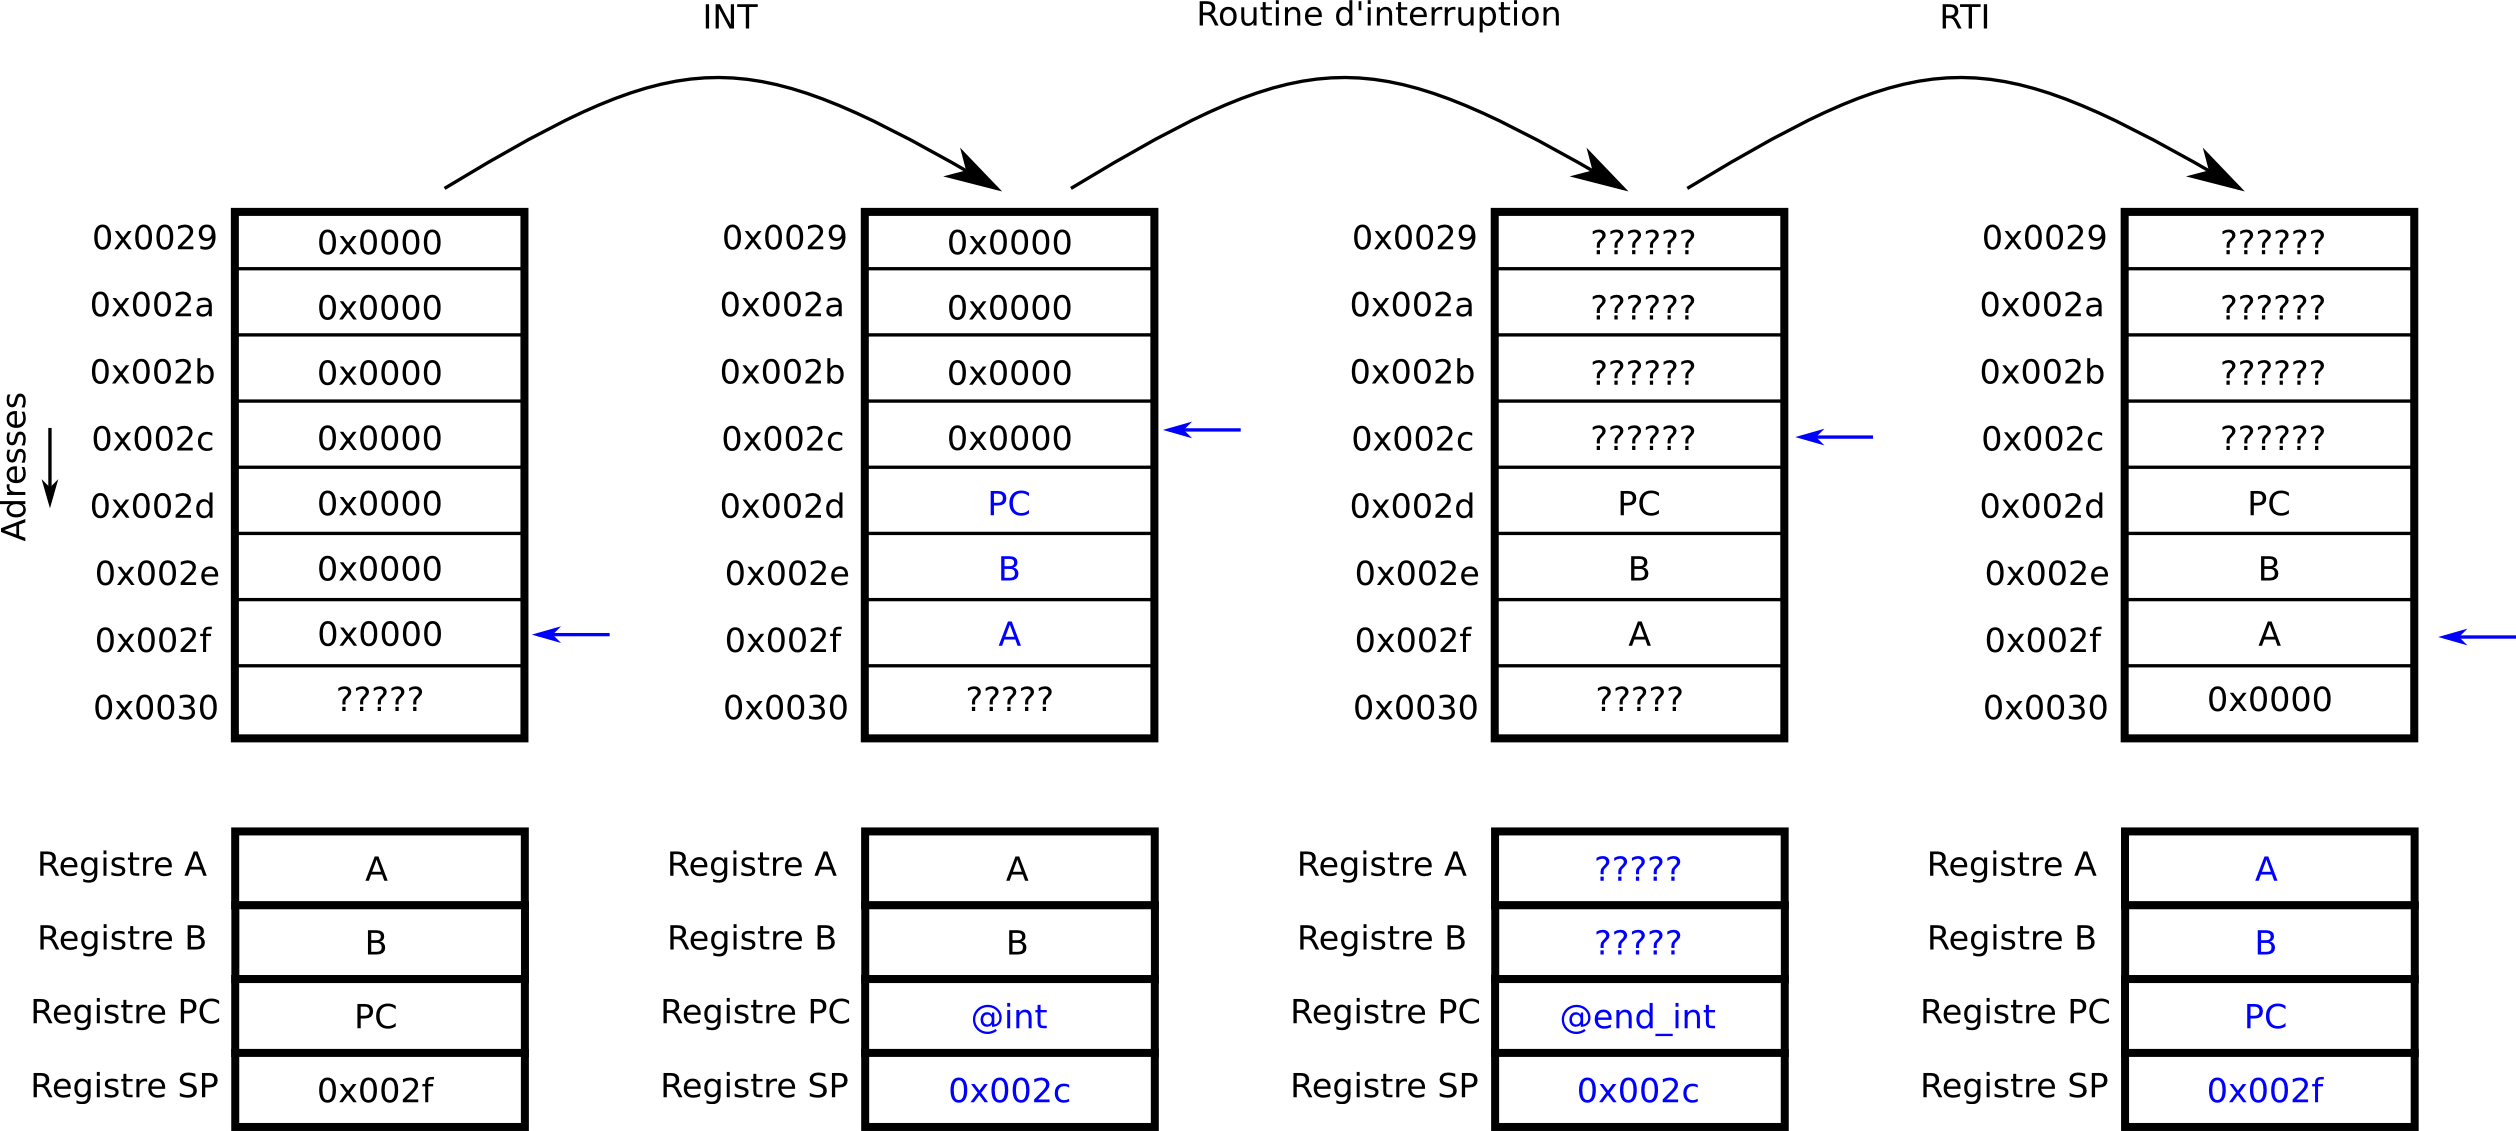
Attention
La gestion de l’interruption implique la pile !! Phase d’initialisation (JMP init) minimale :
# par défaut IF = 0
LDSPI ...
STI
Exemple jouet : En TP
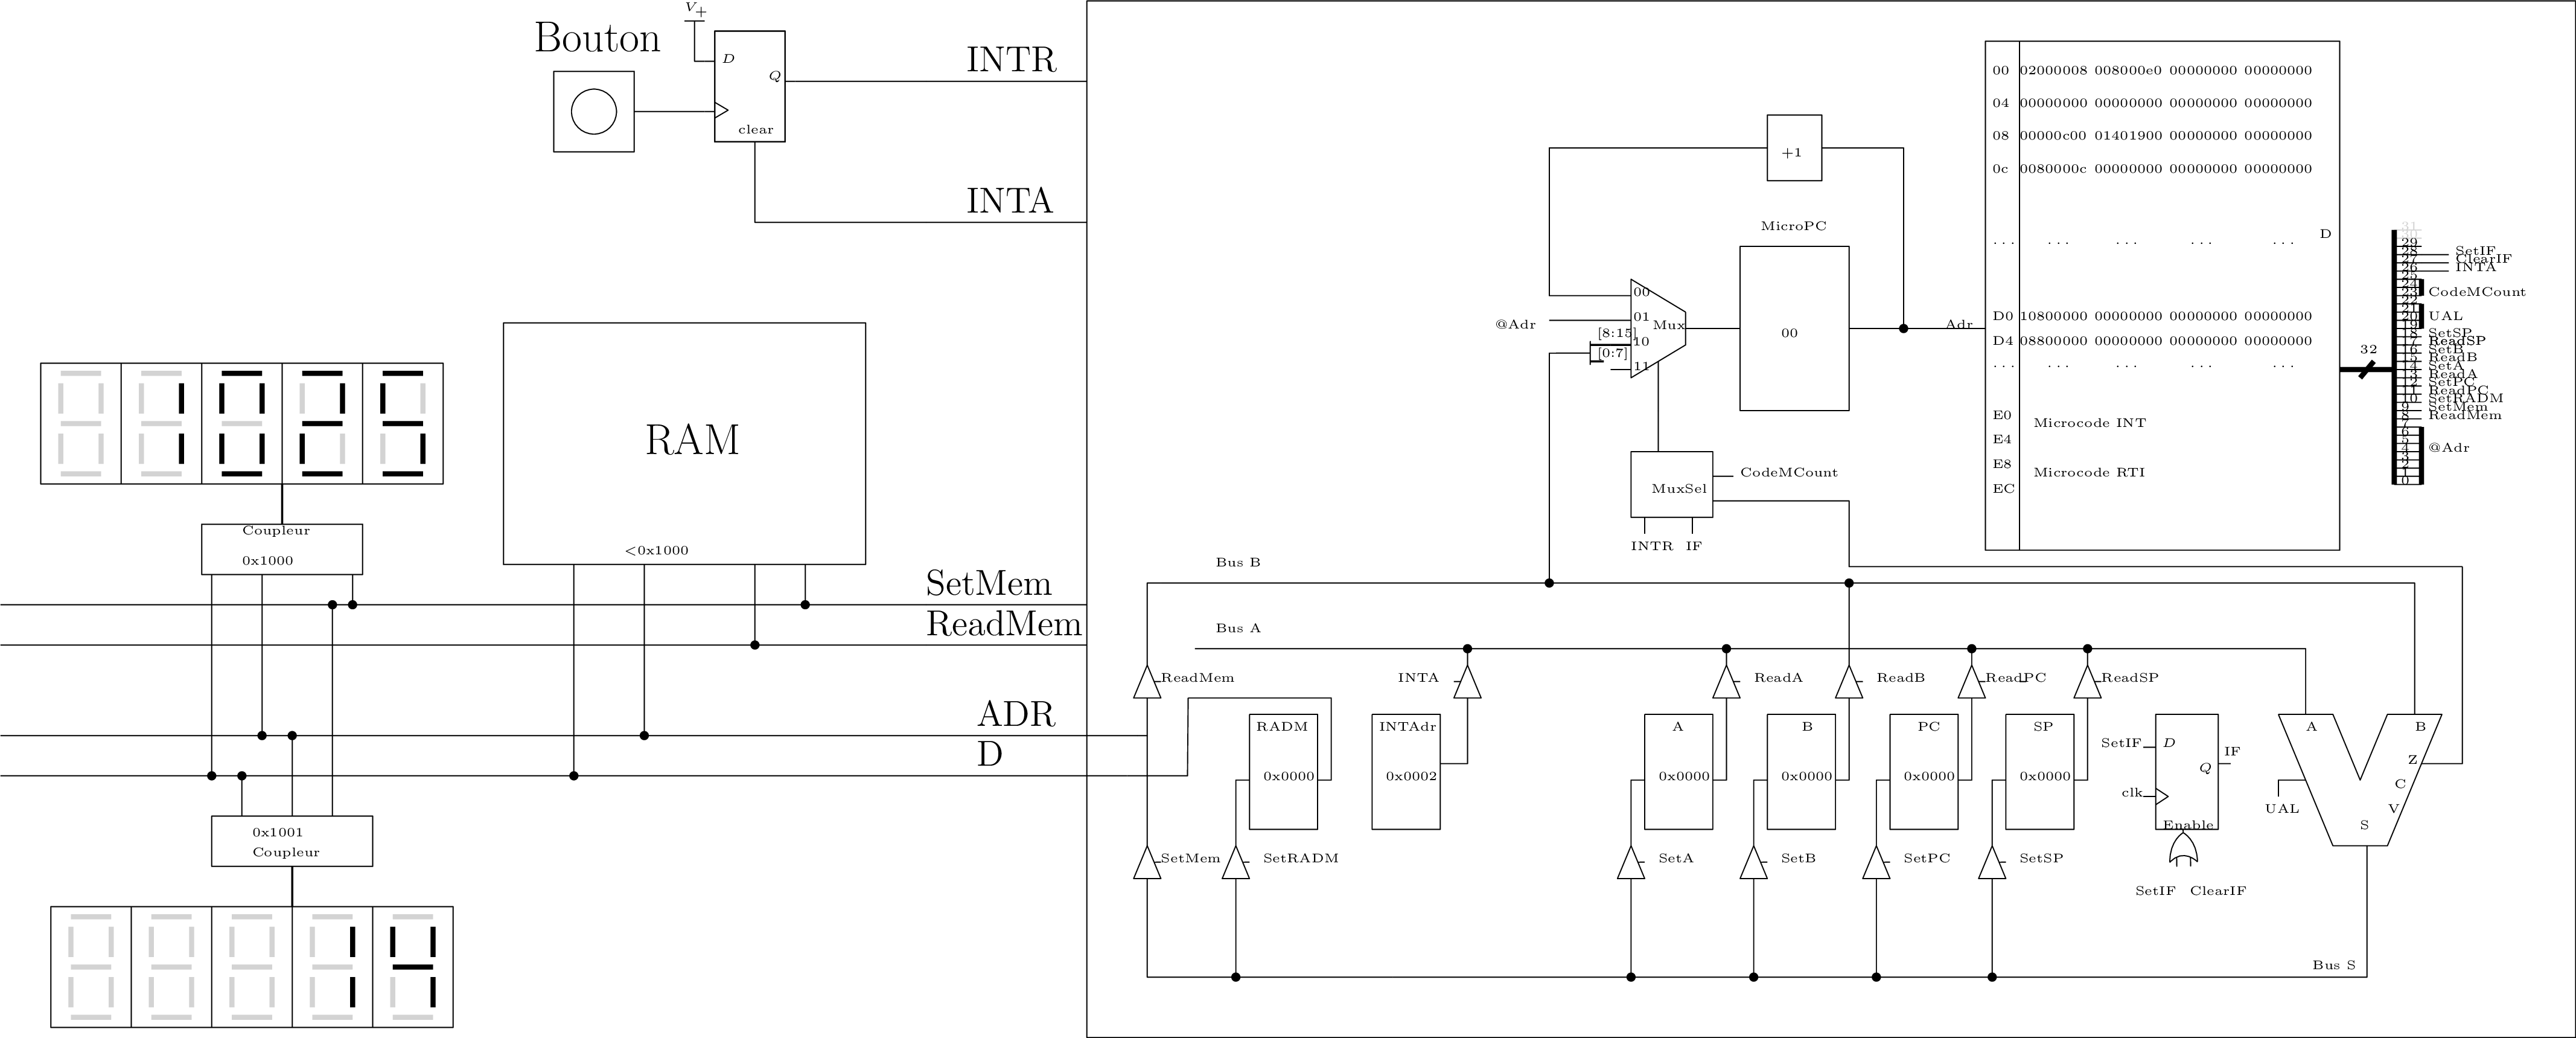
Plusieurs interruptions ?
On s’est limité pour le moment à un seul périphérique.
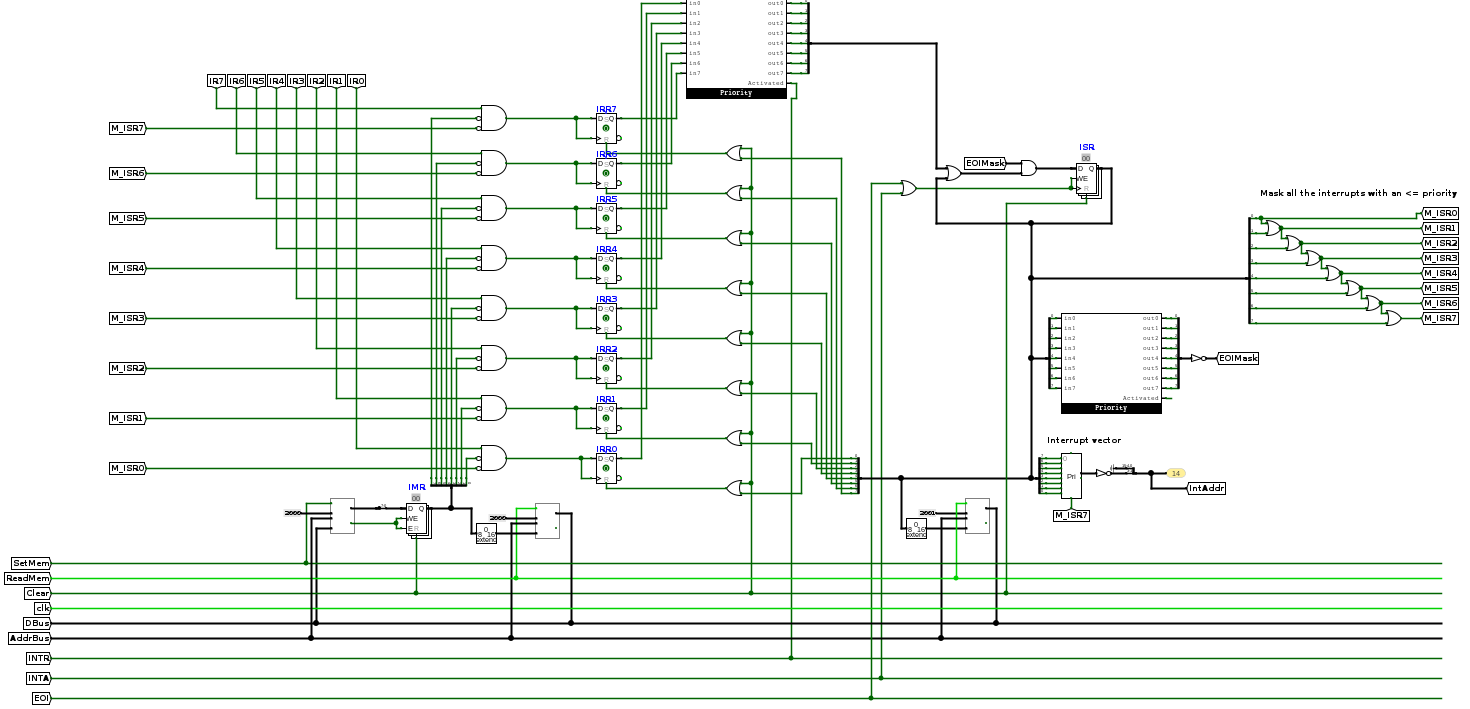
Prise en charge de plusieurs interruptions
- Plusieurs lignes d’interruptions
- Centralisation et arbitrage des demandes d’interruptions; Le vecteur d’interruption est récupéré sur le bus de données
Avec un Programmable Interrupt Controller - PIC - 8259A
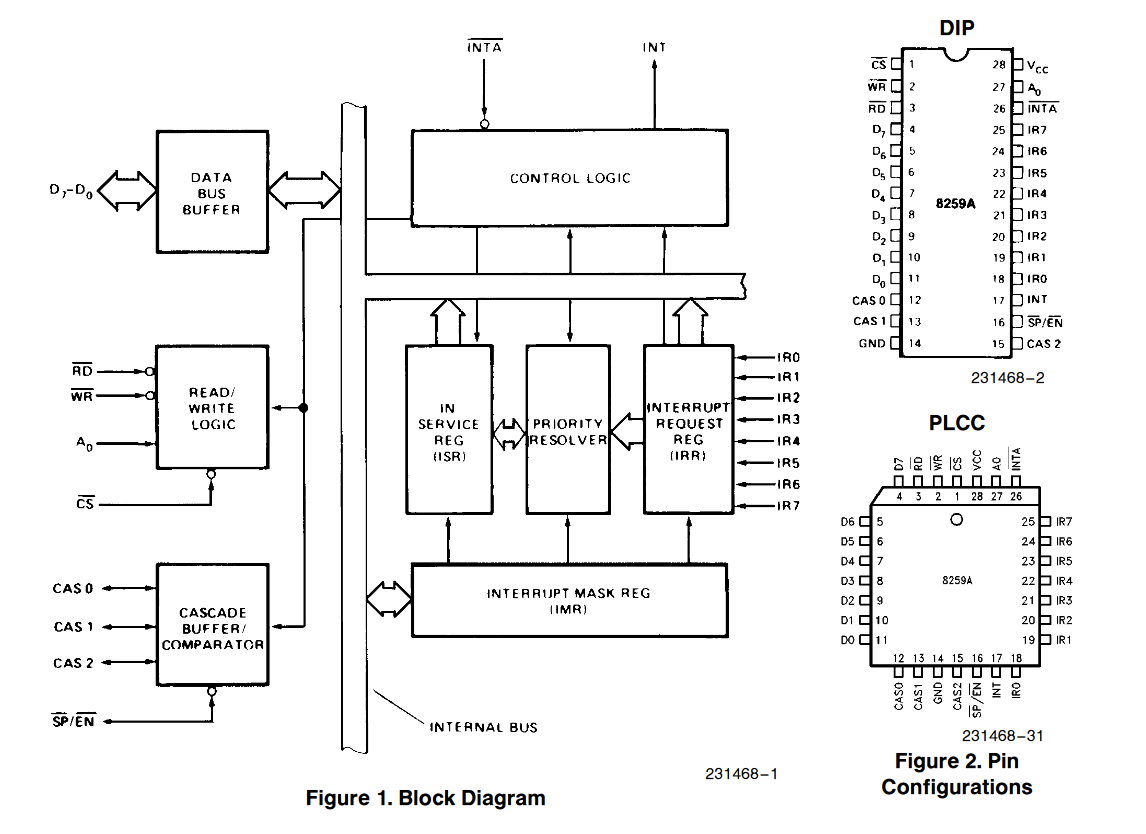
Ordonnanceur
Problème
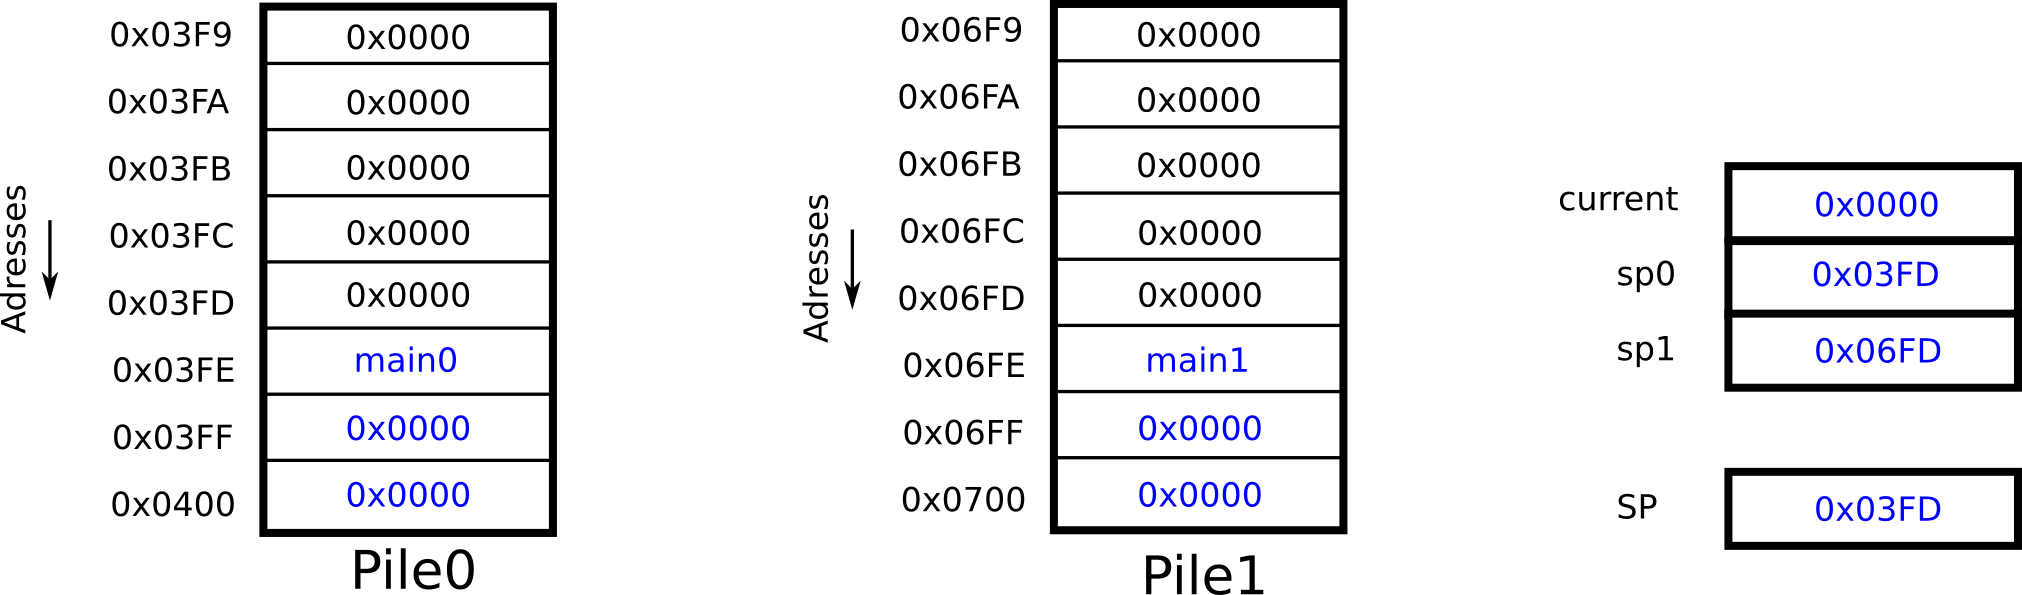
Comment exécuter plusieurs programmes “en même temps” :
- avec plusieurs chemins de données (architectures multi-coeurs)
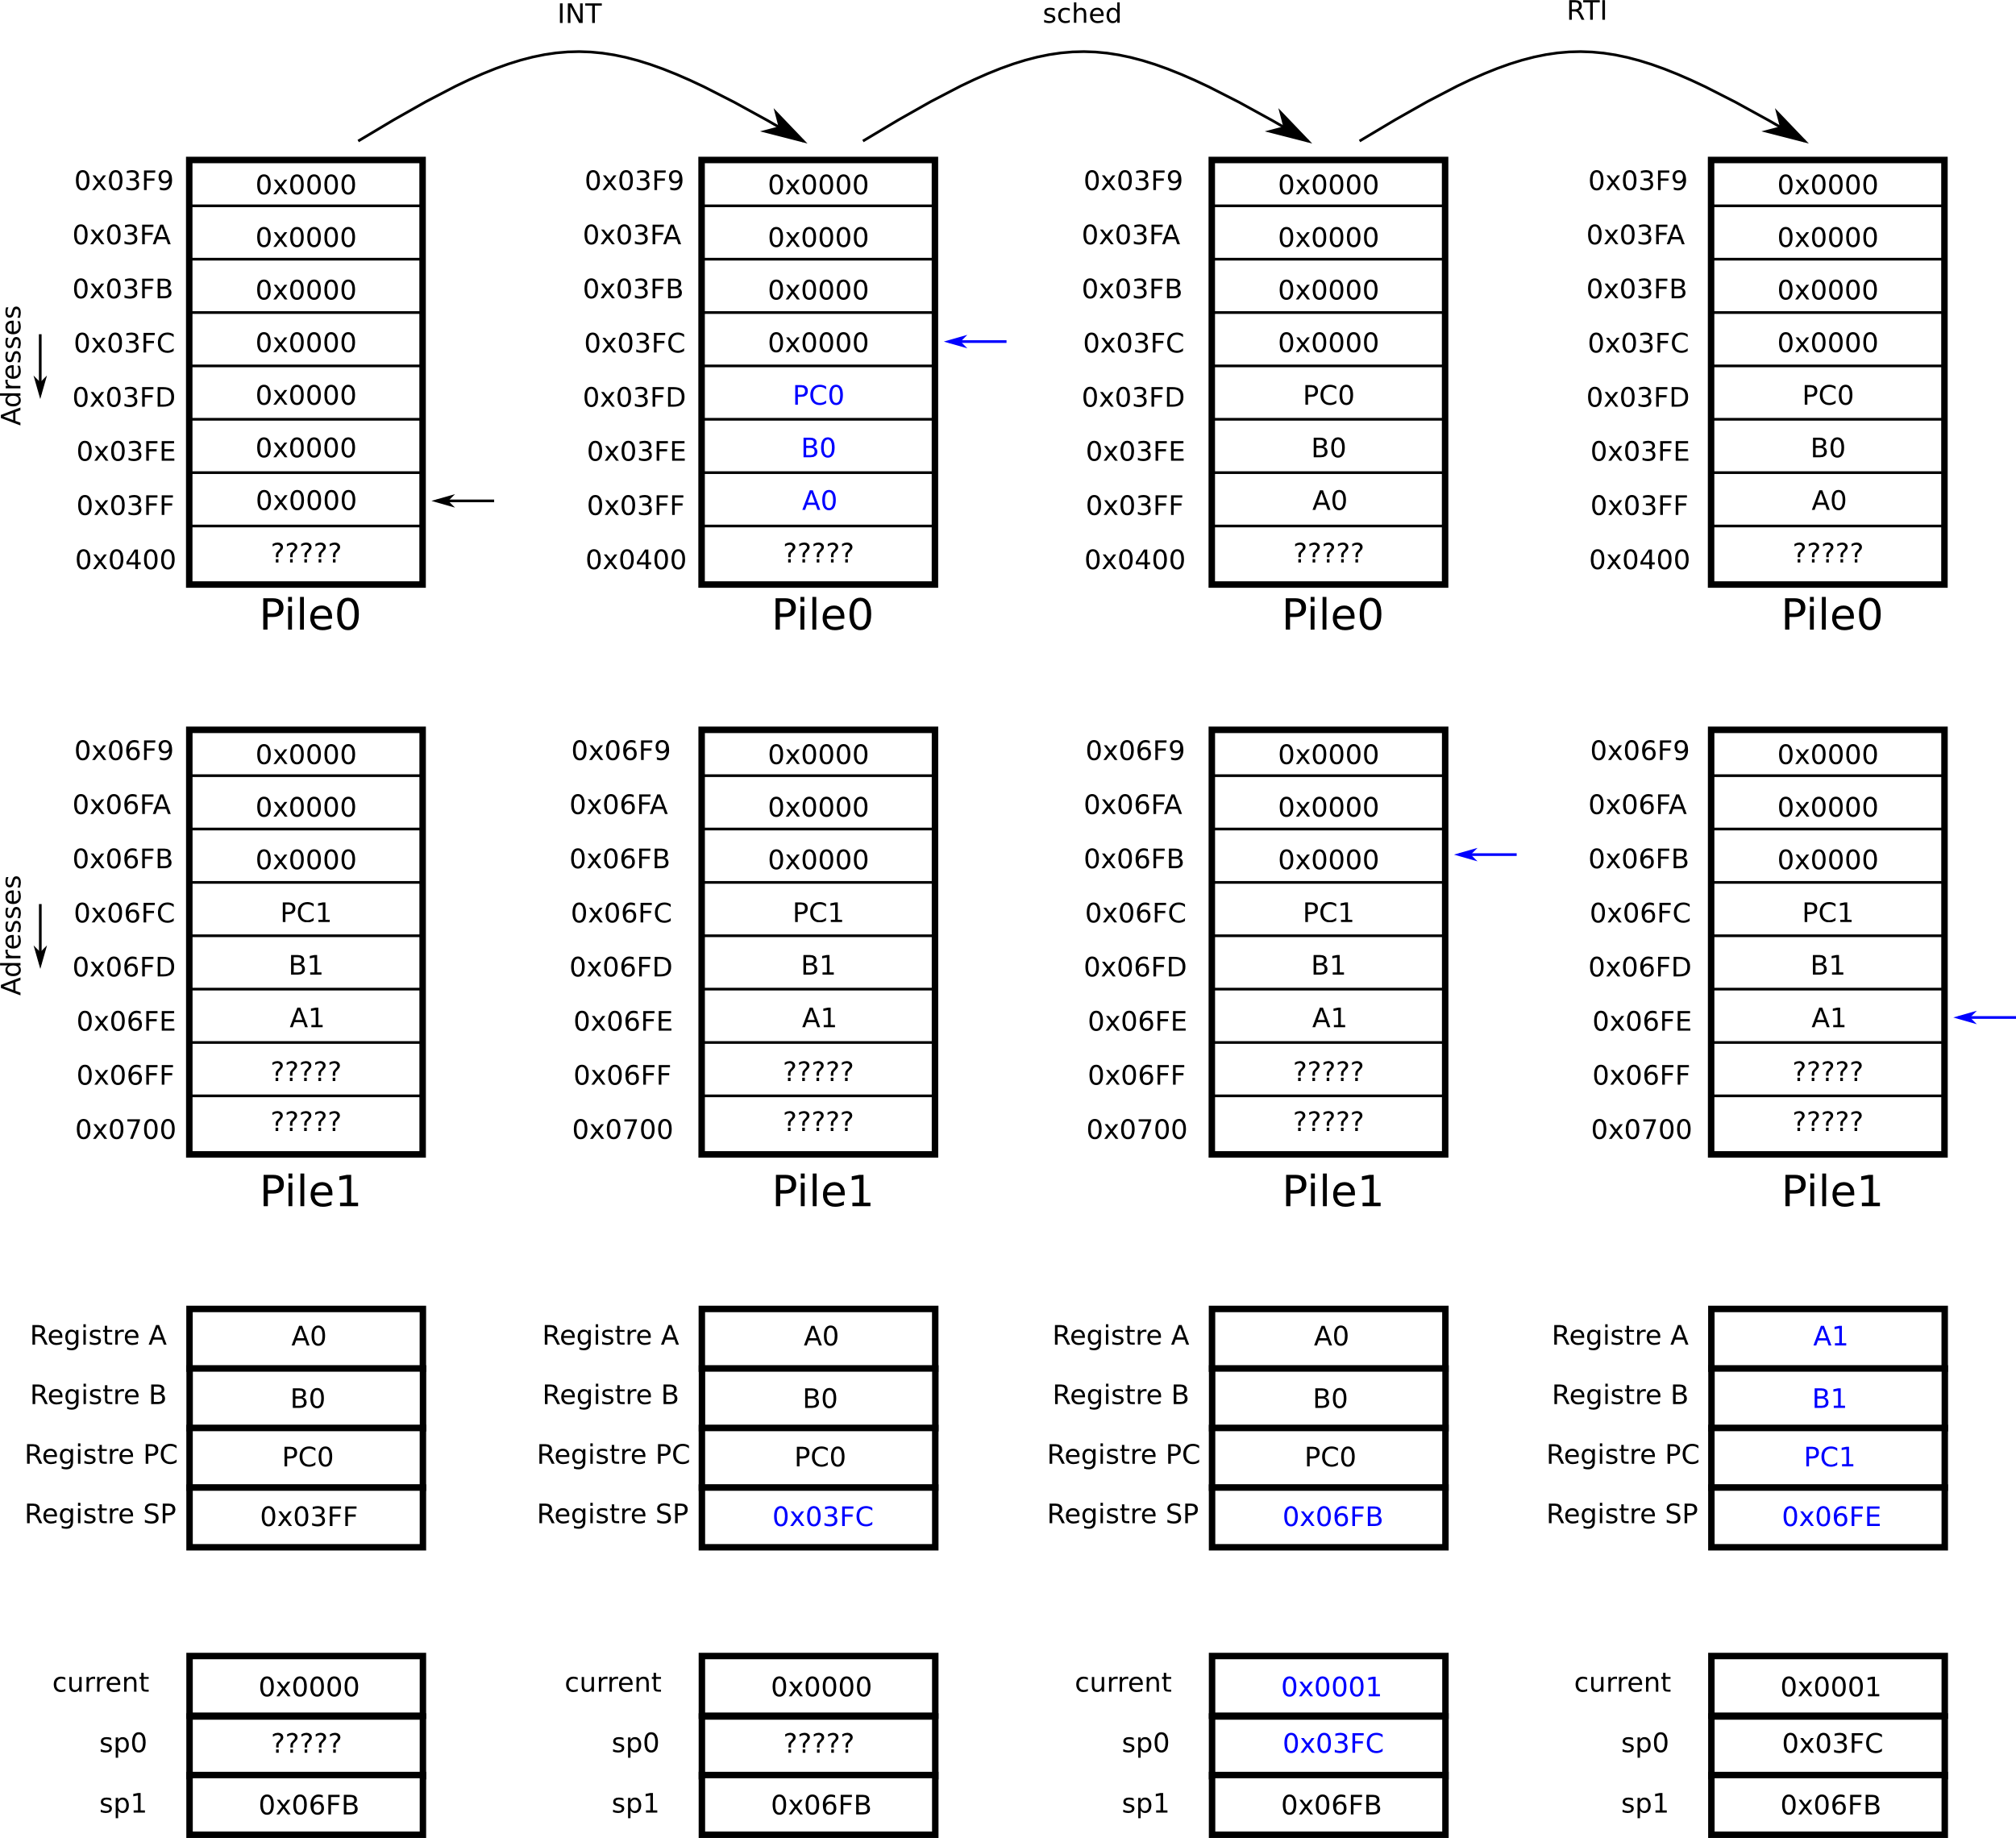
- avec un seul chemin de données partagé par deux programmes avec un basculement de contexte régulier, rythmé par l’interruption d’un timer..
Initialisation
Basculement de contexte
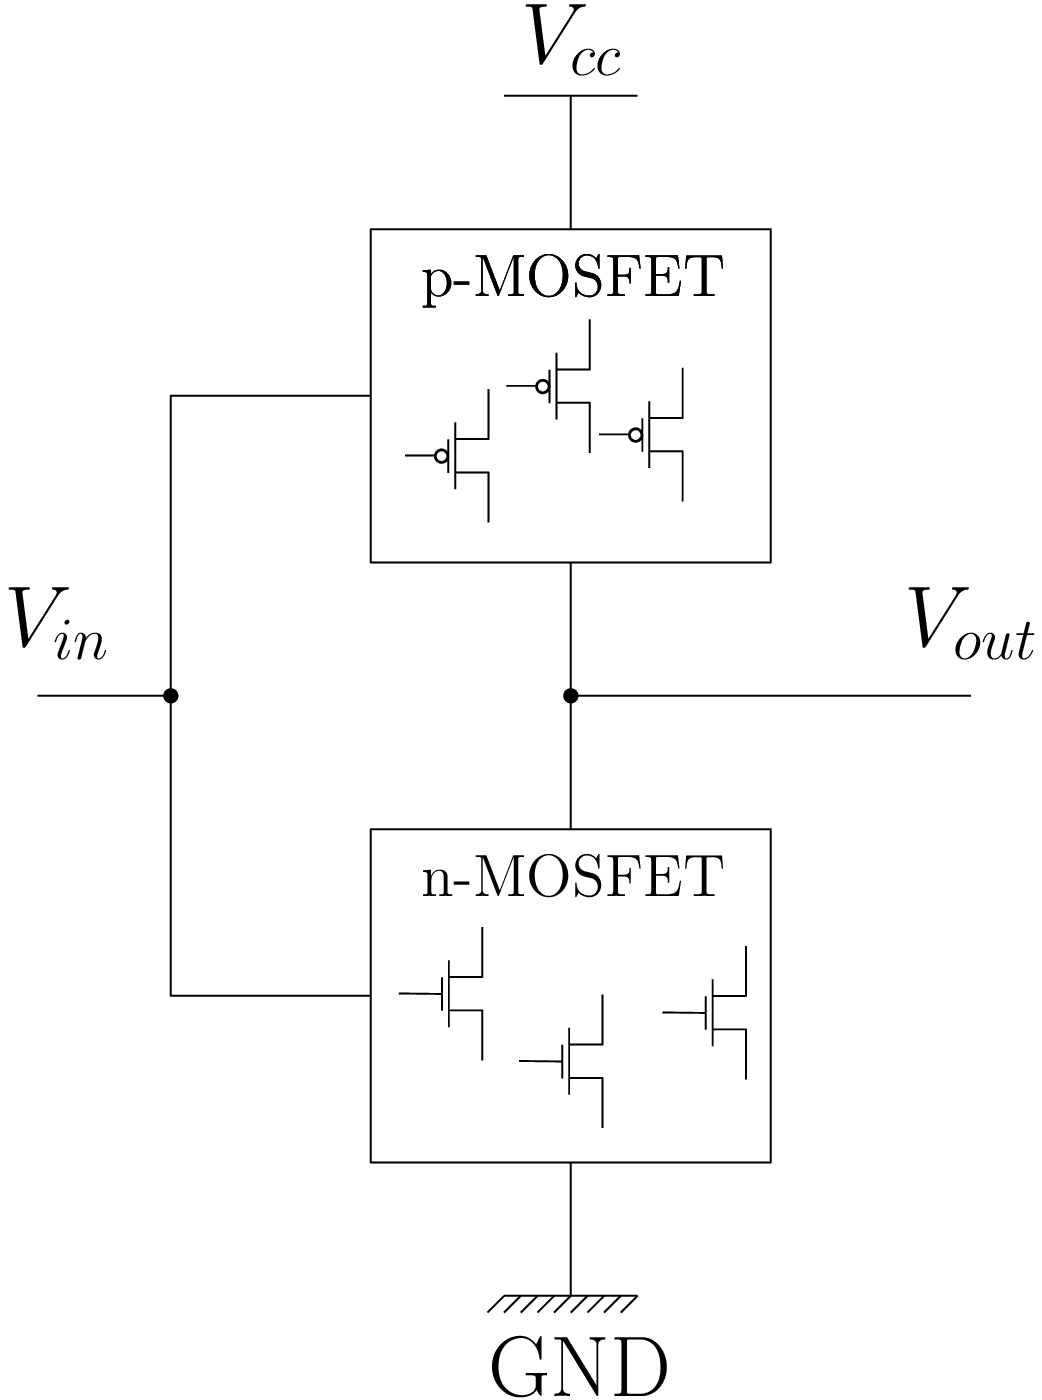
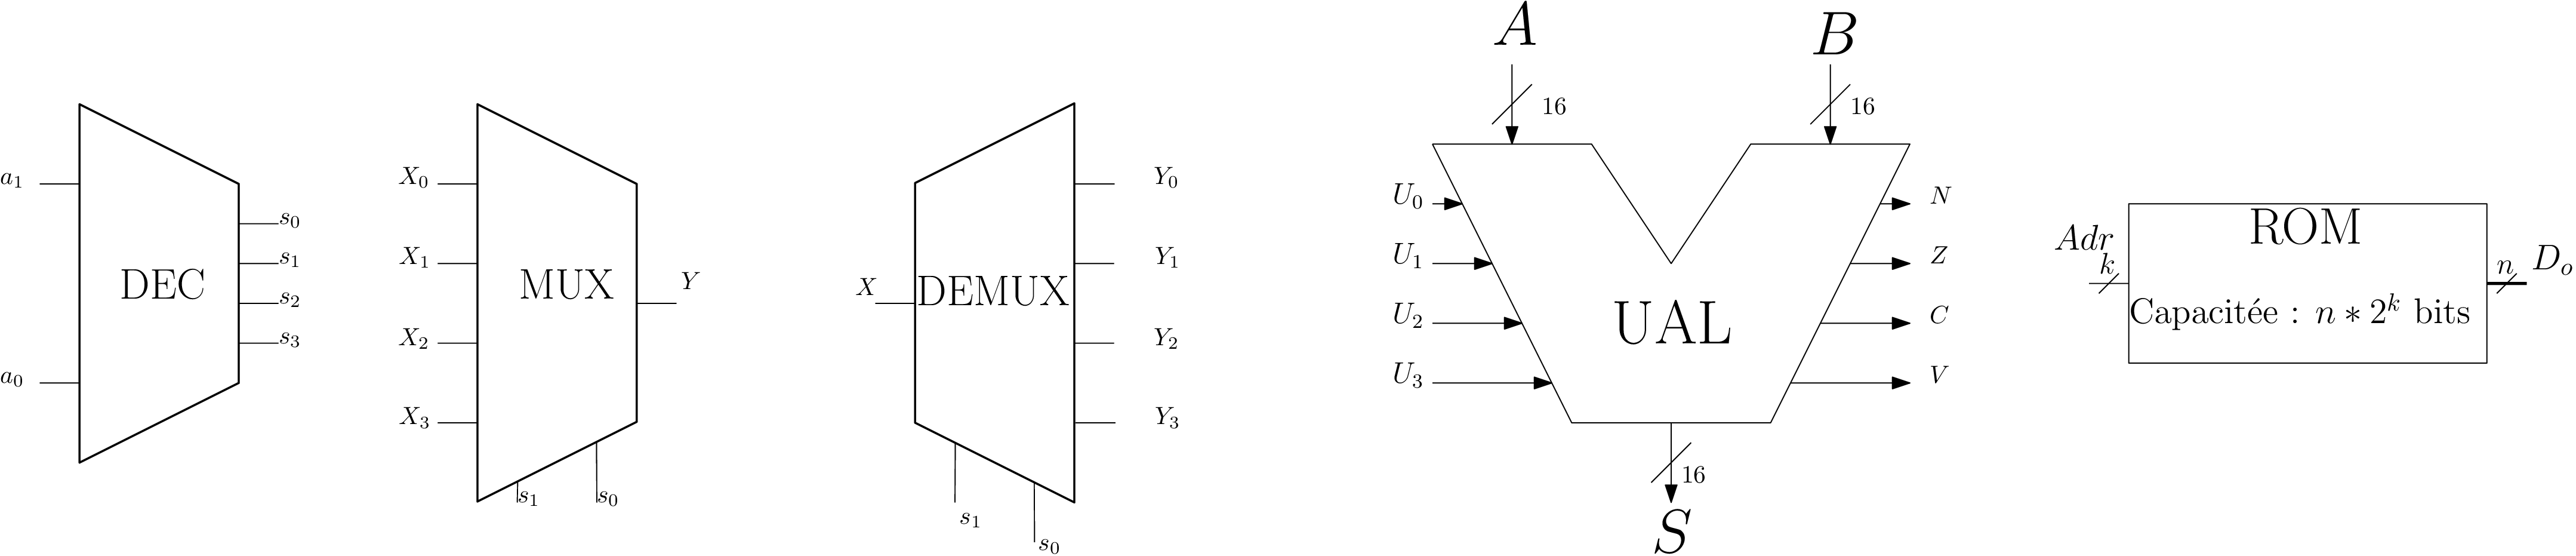
Cours 1-2 : Codage en binaire, Transistors, logique combinatoire
Codage/décodage
Couche physique / logique
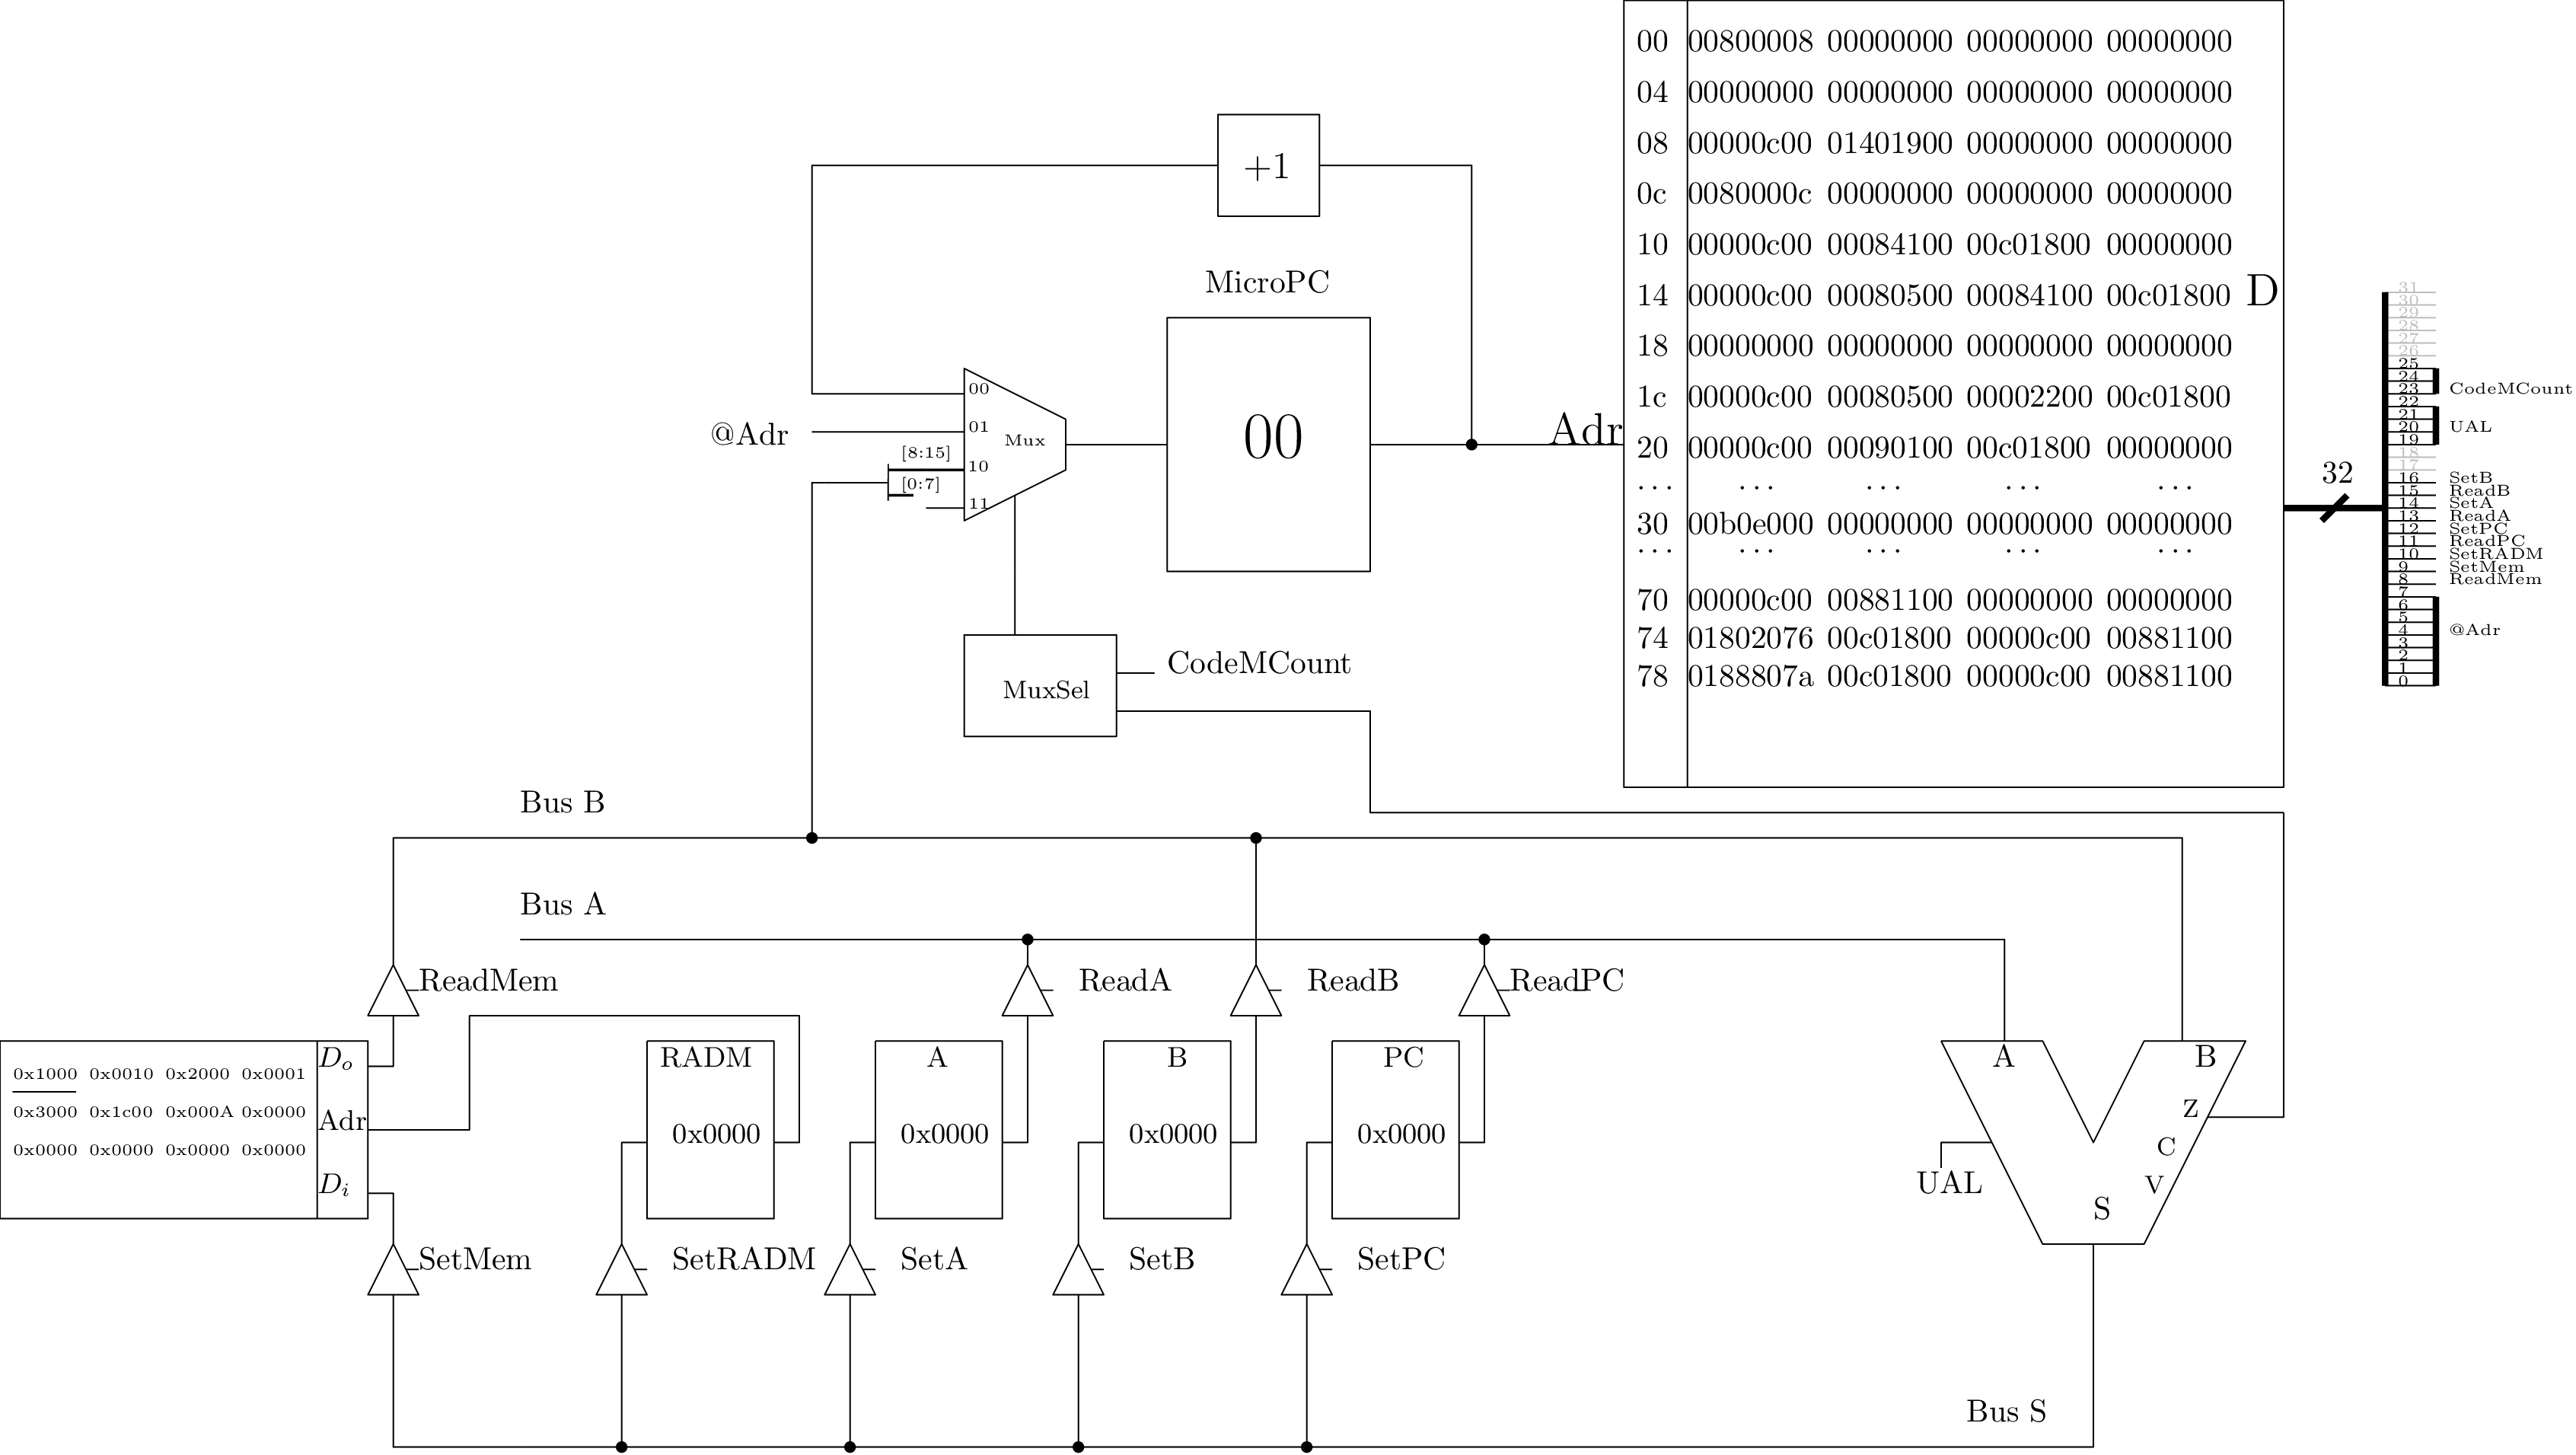
Cours 3-4 : Logique séquentielle, premier chemin de données
Cours 5-6 : pile et programmation
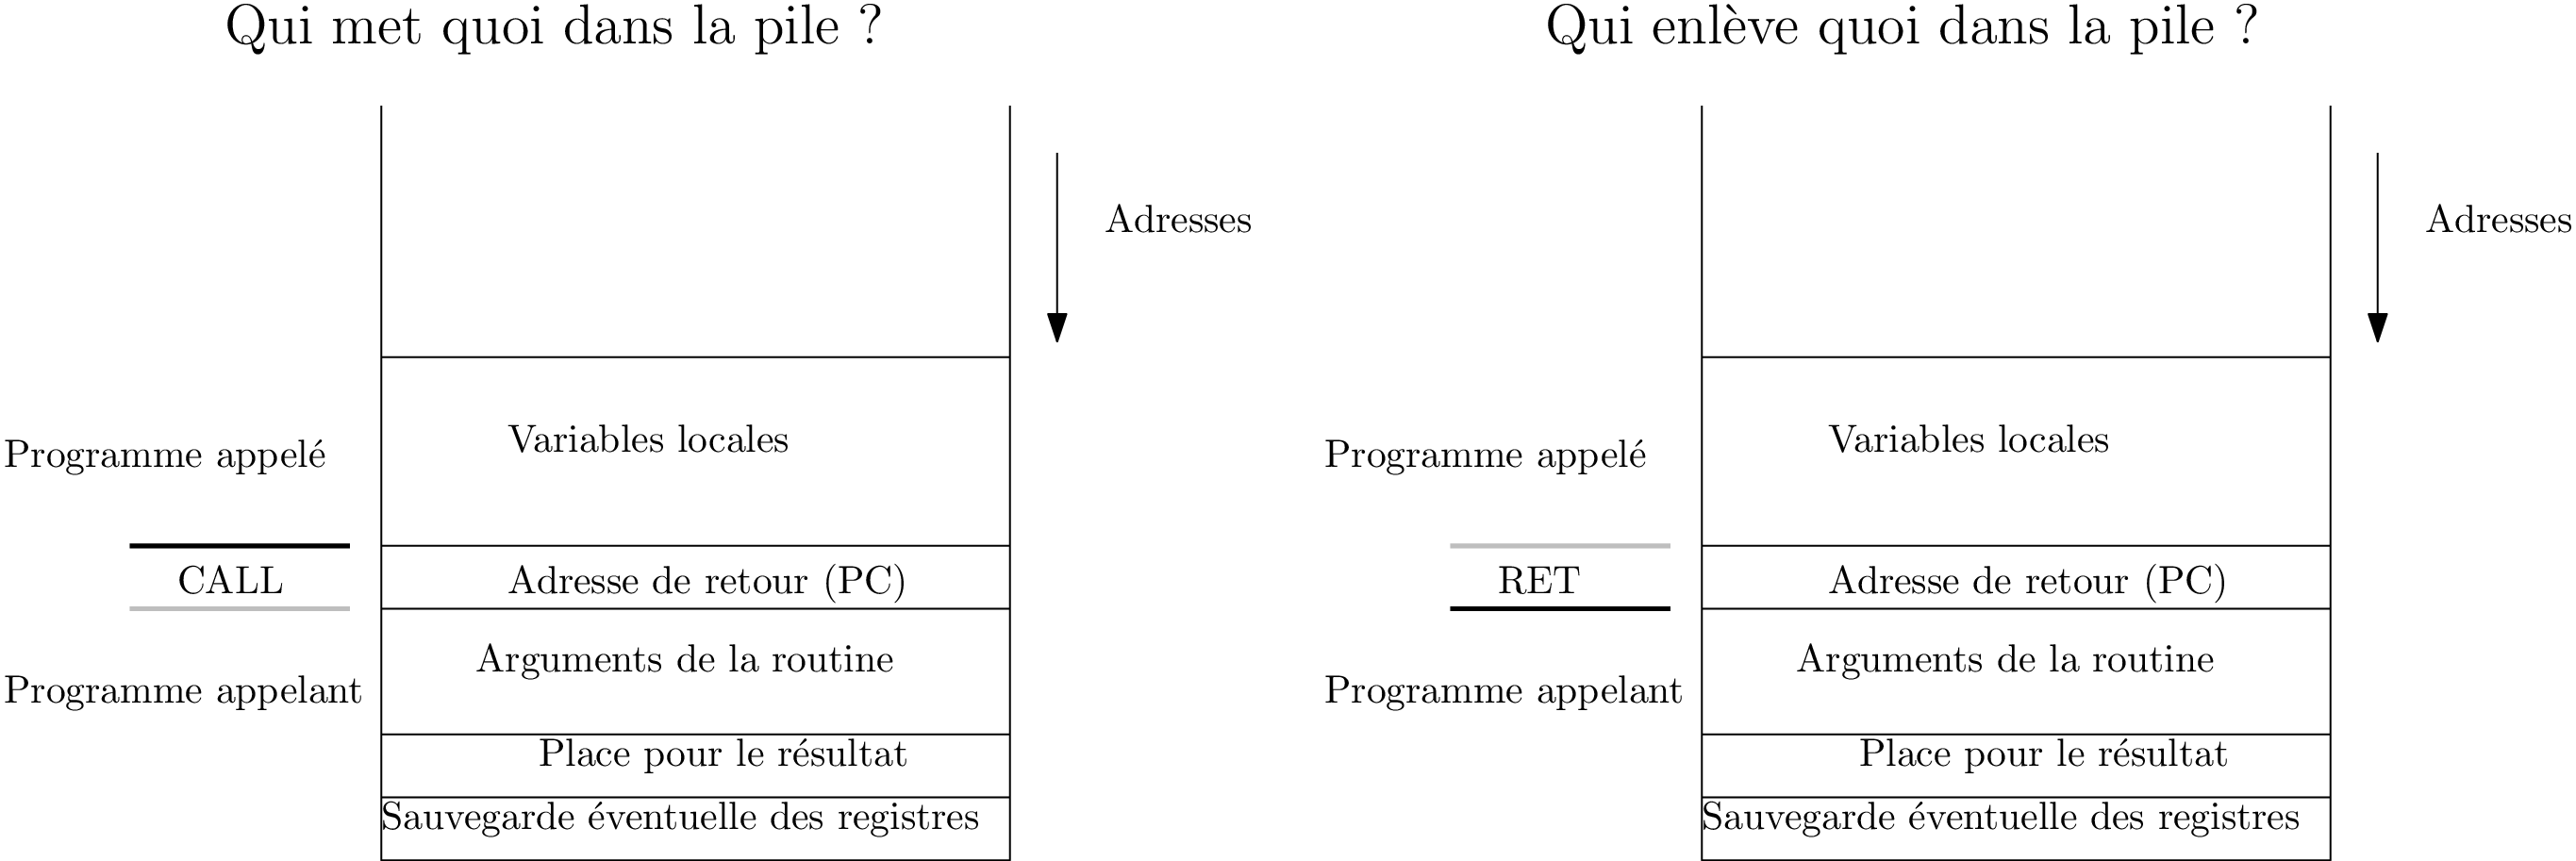
Pile et procédures
Programmation
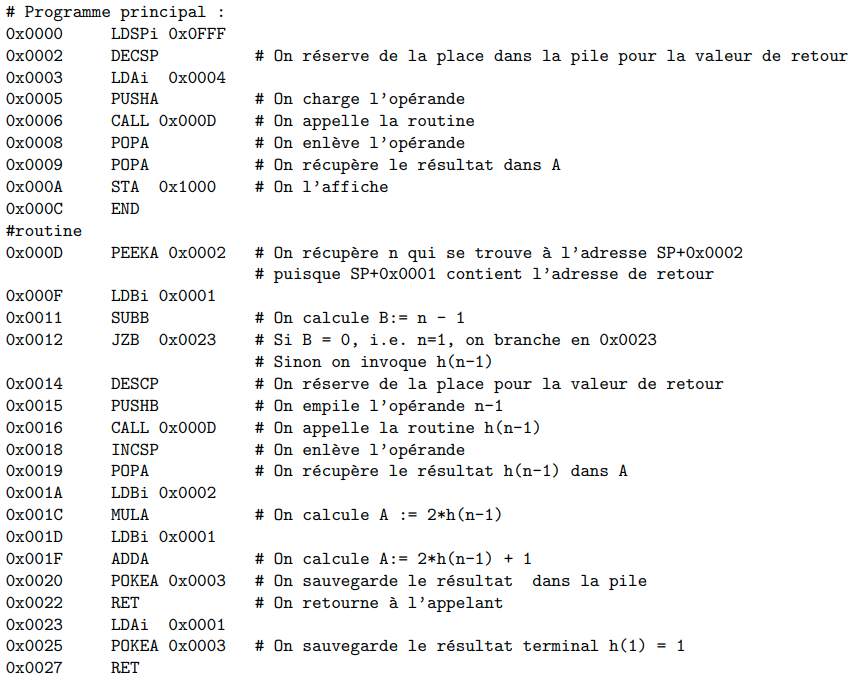
⇒ Ouverture vers la programmation (C++, etc..)
Cours 7 : mémoires caches, périphériques, interruptions
Hierarchie de mémoire
Interruptions
Comment exploiter les principes de localité ?
Solution 1) A la charge du programmeur
→ Pas très pratique…
Solution 2) Hierarchie de mémoires
Performances du cache
Temps moyen d’accès mémoire \(T_m \approx HR. t_{cache} + MR. t_{mem}\)
Pour \(HR = 90\%\) : \(T_m = 17 ns\).